杂谈:对抗攻击
对抗攻击(Adversarial Attacks)是指通过对模型的输入施加扰动或者变换,来让模型产生错误行为的一种攻击方法。早期的对抗攻击主要针对图像分类模型,攻击者通过对输入图像的像素施加微小扰动,即可让模型分类失败。这种扰动通常非常微小以至于肉眼几乎无法察觉,攻击者要做的就是通过解决约束优化问题来求解出施加扰动的方式以让损失函数最大化,进而让模型行为偏离基线水平。不过围绕这一问题不同求解策略催生了不同的攻击手段,FGSM (Ian J. Goodfellow et al., 2015) 是早期的将问题线性化后一步解出闭式解的方法,其他的一些基于迭代求解约束优化问题的攻击方法包括 L-BFGS-B (Christian Szegedy et al., 2014)、C&W 攻击 (Carlini & Wagner, 2017) 、UAP (Moosavi-Dezfooli et al., 2016) 等,关于更多相关攻击算法,可以参考 (Liang et al., 2022)。
而随着 LLM 的发展,一些针对 LLM 的对抗攻击算法也相继涌现。和图像不同,文本是离散符号序列,因此 $L_p$ 范数约束不再适用,攻击的核心变成在离散空间中找到保持语义自然(不是必须),同时能够诱导模型产生错误甚至恶意的输出的离散序列。关于语言模型的攻击方法不纳入本文讨论范围之内,后续有时间再整理。Lilian Weng 写了一篇比较详细的博客讨论了 LLM 对抗攻击的方法,值得参考。
按照攻击者对模型的了解程度,针对模型的攻击大致可以分为白盒攻击(White-box Attack)和黑盒攻击(Black-box Attack)。白盒攻击指的是攻击者可以获取模型的全部权重和架构信息,因此可以通过基于梯度计算的方式生成对抗样本。而黑盒意味着攻击者只能够获取模型的输入和输出,对权重、模型结构一无所知,无法直接计算梯度,也就无法通过梯度优化等方式生成对抗攻击样本了,不过存在通过查询的方式进行梯度估计来构造对抗样本。此外,一些论文指出,部分攻击方法具有可迁移性,通过在白盒模型基于梯度优化生成的对抗样本,可以直接迁移到黑盒模型上进行攻击,且具有较高的成功率,这一点我也会进行探索。
除了白盒攻击和黑盒攻击,还有一些其他的攻击方法如针对训练阶段的后门攻击、面向生成式模型的越狱攻击等等。对于后门攻击本人不是特别感兴趣,因为其需要介入训练阶段,更类似于网络安全领域的攻击,本文不想探索。本文着重讨论白盒攻击和它的迁移性,以及针对模型推理阶段的其他攻击方法。
如果要覆盖整个对抗攻击领域全貌,恐怕篇幅过长,这也不是我探索的本意。因此,本文打算从理论着手,首先对一些针对图像分类模型的早期对抗攻击方法进行探索,大致分析梳理对抗攻击的发展历史,然后选择一些有意义的针对模型推理阶段的白盒对抗攻击方法进行研究和复现。关于早期的一些对抗攻击和防御方法,可以参考 (Alexey Kurakin et al., 2018),关于对抗攻击和对抗训练比较近期的综述可以参考 (Msahli et al., 2026) 。
威胁模型
- 目标:攻击者通过对输入进行扰动和修改,使得神经网络模型效果恶化。这些修改需要难以被人类所察觉 (Msahli et al., 2026) 。
- 知识:通过攻击者对模型的了解程度将攻击进行分类。若攻击者能够获取模型的完整权重和模型结构信息,则知识为 白盒;如果攻击者无法获取模型的完整权重和模型结构信息,仅能够通过输入和输出与模型进行互动,则知识为 黑盒;如果攻击者知道模型的模型权重信息,但是不知道模型采取的防御手段,称之为 灰盒 (Msahli et al., 2026) 。
- 特异性攻击:目标攻击(targeted adv. attacks) 是让模型产生特定的输出;非目标攻击(Untargeted adv. attacks) 是让模型效果变差。
- 攻击能力:攻击者为了执行攻击对输入的修改方式 (Msahli et al., 2026) 。
威胁模型的定义如下 (Laidlaw & Feizi, 2019) :函数 $t: \mathcal{P}(\mathcal{S}) \rightarrow \mathcal{P}(\mathcal{S})$,其中 $\mathcal{S}$ 是模型可能的输入集合,$\mathcal{P}(\mathcal{S})$ 是输入的幂集。因此,攻击者的 攻击能力 可以被定义为将一组输入集合映射为另外一组输入,而对抗样本可被定义如下:
$$ \text{find}\;\hat{x} \; \text{such that}\; \phi(\hat{x}) \neq \phi(x)\; \text{and}\; \hat{x} \in t({x}) \;, $$
其中 $\phi$ 是分类模型,$x$ 是原始输入,$\hat{x}$ 则是对抗样本。
度量扰动大小:$L_p$ 范数
扰动就是对抗样本和原始样本的差异,我们可以将其定义为:
$$ \delta = \hat{x} - x\;, $$
由此可以推出对抗样本:
$$ \hat{x} = x + \delta\;. $$
度量扰动的大小就是计算对抗样本和原始样本的“差距”,在高维空间中,这种差距的表示方法有很多,一般来说通过范数来表示,p-范数 $\| \cdot \|_p$ 为:
$$ \|v\|_p = \left(\sum_{i=1}^d|v_i|^p\right)^\frac{1}{p}\;. $$
设 $\delta$ 是一个维数为 $d$ 的向量。在对抗攻击中常用的范数如下:$L_1$、$L_2$ 和 $L_\infty$。$L_0$ 严格来讲不是范数,但是它在对抗攻击中也是一个常用的度量方式,它指向量中非零元素的个数。
白盒攻击的两个主要类型
白盒攻击的攻击类型有多种类型划分,不过最主流的是两类:
- 基于梯度的攻击,
- 基于优化的攻击。
由 (Christian Szegedy et al., 2014) 提出的对抗样本生成是最早提出的一批针对深度神经网络攻击的方法之一,将生成对抗样本形式化为带边界约束的优化问题,并使用 L-BFGS-B (Byrd et al., 1995) 求解。这类攻击的一般性的思路是将求最小扰动形式化成一个优化问题,通过优化器不断地迭代以获取让模型错误分类的最小扰动代价。包括 L-BFGS-B、C&W、DeepFool (Moosavi-Dezfooli et al., 2016) 等;而 FGSM 等代表的是基于梯度的攻击,通过设置 $\epsilon$,损失函数 $\mathcal{L}(\theta; x, y)$ 对输入 $x$ 求梯度 $\nabla \mathcal{L}$,让其沿着梯度方向移动,让损失增大。除了一步生成的 FGSM 外,还包括多步迭代生成的 PGD (Aleksander Madry et al., 2019)、以及 BIM(也被称为 I-FGSM)(Alexey Kurakin et al., 2017) 等。
除了基于梯度的和基于优化的两类主流的白盒攻击方法类型,其他的还包括基于显著性图(Saliency-based)的 JSMA (Nicolas Papernot et al., 2015),它不算损失梯度,而是算 Jacobian 矩阵 $\partial{Z_i}/\partial{x_j}$,找改动后对目标 logits 产生影响最大的少量像素然后逐个像素进行修改;另外一个是基于生成模型的攻击方法,如 AdvGAN (Chaowei Xiao et al., 2019)、GAP++ (Xiaofeng Mao et al., 2020)。最后还有一类后面我会进行探索的是通用扰动类型攻击 UAP (Moosavi-Dezfooli et al., 2016),其求一个与样本无关的的单一扰动 $\delta$,加到任意的输入上都能够使得模型出错,体现的是攻击方法的泛化性。
L-BFGS 求解对抗样本
牛顿法
我们从牛顿法开始,逐步讨论为什么 (Christian Szegedy et al., 2014) 要提出使用 L-BFGS 来搜索对抗样本。
想象一个二次函数 $f(x) = \frac{c}{2} x^2 + b x + a$,当 $c > 0$,该函数是一个严格凸函数,其唯一的驻点 $x^\ast = - \frac{b}{c}$ 是函数的最小值点。由 $f’(x) = c(x - x^\ast)$,可以得到最小值点的位置:
$$ x^\ast = x - \frac{f’(x)}{c}\;. $$
牛顿法就是这种走一步找驻点的算法,在每次迭代中构造当前点处的二阶泰勒模型,并以该二次模型的驻点作为下一个迭代点。对于二次函数,该模型是精确的,因此牛顿法可以一步到达驻点;对于一般函数,则通常需要多次迭代。,我们只需要将上面的一元函数扩展到多元,将一、二阶导数引申到梯度和 Hessian 矩阵上即可。给定 $f(x)$,其中 $x \in \mathbb{R}^n$,我们的目标是最小化 $f(x)$,即找到 $\nabla_x(f)$ = 0 的点。首先我们对 $f(x)$ 进行二阶泰勒展开:
$$ f(x) \approx f(x_k) + \nabla_{x_k} f^\top(x-x_k) + \frac{1}{2}(x-x_k)^\top \mathbf{H}_k (x-x_k) \;, $$
其中 $\mathbf{H}_k = \nabla_{x_k}^2 f$ 为 $f$ 关于 $x$ 在 $x_k$ 处的 Hessian 矩阵。设右边为 $m(x)$,则要求解函数的驻点,即求右边关于 $x$ 的梯度,所以对模型求一次梯度,然后将梯度赋 0:
$$ \nabla m(x) = \nabla_{x_k} f + \mathbf{H}_k(x-x_k) \;, $$
令 $\nabla m(x)$ = 0,求得:
$$ x_{k+1} = x_k - \mathbf{H}_k^{-1} \nabla_{x_k} f \;. $$
牛顿法无需调整迭代的学习率,但是计算量极大,对黑塞矩阵求逆运算的复杂度为 $O(n^3)$,同时,对于不同正定性的黑塞矩阵求解的结果不一定是极小值点。在驻点 $x^\ast$ 处:
| Hessian 特征值 | 曲面形状 | 驻点类型 |
|---|---|---|
| 正定 | 碗状,严格凸 | 局部极小值点 |
| 负定 | 拱形 | 局部极大值点 |
| 不定 | 马鞍面 | 鞍点 |
相较于 SGD($\theta_{k+1} = \theta_k - \eta \nabla_{\theta_k} f$,其中 $\eta$ 是学习率),牛顿法对学习步长有着更加精细化的控制。从几何上看,Hessian 矩阵捕捉到的是 $f$ 在 $x_k$ 处的曲率,梯度 $\nabla f$ 捕捉的是梯度,这两者可以告诉我们从当前点到驻点需要走的步长值,使用 Hessian 矩阵的逆矩阵乘以负梯度,可以知道对所有方向我们需要走的步长大小,在函数急剧变化的地方可以减少步长,而在函数平缓的地方增大学习步长。如果目标函数本身是一个凸二次函数,牛顿法可以一步找到最小值。
拟牛顿法
牛顿法可以说是一种非常理想化的求解方式了,但是在现实层面却又不可行。似乎我们总是遇到这种场景,在理想与现实间疯狂的寻找折衷。牛顿法引入曲率可以很快找到驻点,但是在大规模机器学习场景中往往存在计算和存储的瓶颈。拟牛顿法就是希望在不通过直接求 Hessian 矩阵逆矩阵的情况下,通过梯度差迭代计算二阶曲率来降低计算的复杂程度。
我们再用一元二次函数来描述,我们知道对于 $f(x)$,要求它在 $x_k$ 处的斜率可以通过割线法进行近似:$f’(x_{k}) \approx \frac{f(x_{k+1}) - f(x_k)}{x_{k+1} - x_k}$,扩展到二阶就是 $f”(x_k) \approx \frac{f’(x_{k+1})-f’(x_k)}{x_{k+1}-x_k}$。我们将公式引申到高维,目标是去找到一个矩阵 $B_k$ 去近似 Hessian 矩阵。定义两次迭代过程中的参数变化:
$$ s_k = x_{k+1} - x_k\;, $$
$$ y_k = \nabla_{k+1} f - \nabla_k f \;. $$
拟牛顿法就是要维护一个矩阵 $B_k$,要求其满足割线条件:
$$ B_{k+1} s_k = y_k\;, $$
设逆 Hessian 近似矩阵 $H_{k+1} = B^{-1}_{k+1}$,则有:
$$ H_{k+1} y_k = s_k\;. $$
割线条件是对拟牛顿法的约束,但是并没有指出如何去更新近似矩阵,这也是为什么会存在很多种不同的拟牛顿方法的原因,不同的拟牛顿法在满足割线条件约束的情况下,对于近似矩阵的迭代方式是不同的。割线条件是一个向量等式,包含 $n$ 个方程,但近似矩阵 $B_k$ 是一个有 $\frac{n(n+1)}{2}$ 个自由参数的对称矩阵,因此有无穷多个矩阵满足条件。
对于 BFGS,通常希望 $B_k$ 正定,以保证对应的二次模型严格凸,并且使搜索方向为下降方向。若 $B_k$ 正定,则$s_{k}^\top y_k > 0$ 可以保证更新后的 $B_{k+1}$ 仍然正定。Wolfe 线搜索能够保证这一曲率条件,而仅使用 Armijo 条件通常不能。
$$ s^\top_k B_{k+1} s_k = s^\top_k y_k > 0\;, $$
对于一般函数,需要使用 Wolfe 准则 线搜索找到合适的步长来保证曲率条件成立,如果仅仅使用 Armijo 无法使得正定条件成立。
拟牛顿法有一个一般框架,下面给出:
\begin{algorithm}
\caption{拟牛顿算法框架}
\begin{algorithmic}
\REQUIRE $x^0 \in \mathbb{R}^n$,初始矩阵 $B^0 \in \mathbb{R}^{n \times n}$(或 $H^0$)。$k = 0$
\WHILE{未达到停机准则}
\STATE 计算方向 $d^k = -(B^k)^{-1} \nabla f(x^k)$ 或 $d^k = - H^k \nabla f(x^k)$
\STATE 通过线搜索找到合适步长 $\alpha_k > 0$,令 $x^{k+1} = x^k + \alpha^k d^k$
\STATE 更新 Hessian 的近似矩阵 $B^{k+1}$ 或其逆矩阵的近似矩阵 $H^{k+1}$
\STATE $k \leftarrow k + 1$
\ENDWHILE
\end{algorithmic}
\end{algorithm}
从几何的角度,我们使用牛顿法算出 Hessian 矩阵本质上就是对局部的每一处地势都有了掌握,知道其相对于最低点的陡峭情况;而对于拟牛顿法,我们走一小步并记录当前梯度的变化数据,然后结合步长近似计算 Hessian 矩阵来判断当前点的陡峭情况,这种方法不需要去计算全部的 $n^2$ 个元素,大大降低了计算的复杂程度。
矩阵更新
拟牛顿法的关键是如何更新近似矩阵,常见的拟牛顿矩阵的更新方式包括秩一更新和 BFGS(秩二更新)。
秩一更新
秩一更新(SR1)是最简单的近似矩阵更新公式,其通过待定系数法求解修正矩阵来更新 $B_k$。设:
$$ B_{k+1} = B_{k} + auu^\top\;, $$
其中 $u \in \mathbb{R}^n$,$a \in \mathbb{R}$ 待定。根据割线条件,有:
$$ B_{k+1} s_k = (B_{k} + auu^\top)s_k = y_k\;, $$
故
$$ (a u^\top s_k)u = y_k - B_k s_k\;. $$
其中 $au^\top s_k$ 是一个标量,因此 $u$ 和 $y_k - B_k s_k$ 方向一致。这里 $au^\top s_k$ 取任意值不会影响 $u$ 的方向,不妨令 $au^\top s_k = 1$,则有
$$ a (y_k - B_k s_k)^\top s_k = 1\;, $$
假设满足 $y_k - B_k s_k \ne 0$ 且 $(y_k - B_k s_k)^]top s_k \ne 0$,则有
$$ a = \frac{1}{(y_k - B_k s_k)^\top s_k}\;,\\ \;\\ u = y_k - B_k s_k $$
将其代入到近似矩阵的更新公式中得到:
$$ B_{k+1} = B_{k} + \frac{(y_k - B_k s_k)(y_k - B_k s_k)^\top}{(y_k - B_k s_k)^\top s_k}\;. $$
同理,基于相同的过程,我们易得到
$$ H_{k+1} = H_{k} + \frac{(s_k - H_k y_k)(s_k - H_k y_k)^\top}{(s_k - H_k y_k)^\top y_k}\;. $$
SR1 是最简单的近似矩阵更新公式,但是其无法保证更新得到的近似矩阵一定是正定的。因此在实际条件下较少使用 SR1 公式。
BFGS
为了解决秩一更新近似矩阵不正定的问题,Broyden、Fletcher、Goldfarb、Shanno 各自独立提出了 BFGS 算法。考虑对 $B_{k+1}$ 的秩二更新:
$$ B_{k+1} = B_k + a u u^\top + b v v^\top\;, $$
其中 $a, b \in \mathbb{R}$,$u, v \in \mathbb{R}^n$ 待定。将其代入割线条件:
$$ (B_k + a u u^\top + b v v^\top)s_k = y_k \;, $$
得到
$$ a u u^\top s_k + b v v^\top s_k = y_k - B_k s_k \;, $$
通过选取 $u$、$v$ 让上面的等式成立,实际上,$u$、$v$ 有非常多的取法,其中一种取法是 $u = y_k$,$v = B_k s_k$,也就是让等式左边项和右边项进行对应,前面标量系数为直接取符号,故
$$ \begin{aligned} a u^\top s_k &= 1\;, \\ b v^\top s_k &= -1\;, \end{aligned} $$
将 $u = y_k$,$v = B_k s_k$ 代入得:
$$ \begin{aligned} a &= \frac{1}{y_k^\top s_k}\;, \\ b &= \frac{-1}{(B_k s_k)^\top s_k}\;, \end{aligned} $$
因此,得到更新方式为:
$$ B_{k+1} = B_k + \frac{y_k y_k^\top}{y_k^\top s_k} - \frac{B_k s_k (B_k s_k)^\top}{(B_k s_k)^\top s_k} \;. $$
上式称为 $B_k$ 的 BFGS 公式。设逆近似矩阵为 $H_k$,则 $H_k = (B_k)^{-1}$,根据 Sherman–Morrison–Woodbury 公式,可以推知:
$$ H_{k+1} = (I - \rho_k s_k y_k^{\top}) H_k (I - \rho_k y_k s_k^\top) + \rho_k s_k s_k^\top \;. $$
其中 $s_k = x_{k+1} - x_k$ 是位移,$y_k = \nabla f(x_{k+1}) - \nabla f(x_{k})$ 是梯度差,$\rho_k = 1 / (y_k^\top s_k)$。
L-BFGS(Limited-memory BFGS)
在 (Christian Szegedy et al., 2014) 中提出使用 L-BFGS-B,也就是带边界约束的(Box-constrained,所谓的 B)L-BFGS 优化查找对抗样本的攻击方法。之所以要带边界约束,就是将每个变量 $x_i$ 限制在 $l_i \le x_i \le r_i$ 内,这对图像攻击很重要,因为需要将像素限制在合法范围内。
其攻击目标是,给定一张可以被模型 $\phi$ 正确分类的图片 $x \in [0, 1]^m$ 和标签 $l$,满足 $\phi(x) = l$,攻击者希望找到一个人眼难以察觉的扰动 $\delta$,使得 $x’ = x+\delta$ 会被网络错误分类,这个 $x’$ 就是对抗样本。Szegedy 等人把这个问题表述为一个带约束的优化问题,其基本形式是:
$$ \begin{aligned} & \min_\delta \; \|\delta\|_2 \\ & \text{s.t.}\; \phi(x + \delta) = l’, \; x + \delta \in [0, 1]^m \;. \end{aligned} $$
要解决这个带约束优化问题,Szegedy 等人提出使用 L-BFGS-B 方法求解,优化求解的目标形式如下:
$$ \begin{aligned} & \min_\delta\; c\,|\delta|_2 + \mathcal{L}(\theta; x + \delta, l’) \\ & \text{s.t.}\; c > 0,\; x + \delta \in [0, 1]^m \;. \end{aligned} $$
求解 L-BFGS 的方法可以参考这篇教程。
Szegedy 等在三个不同模型和数据集实验设置上全部都找到了对抗样本。通过进一步实验,验证了不同架构,且在不同训练集上训练的模型发现的对抗样本存在迁移性。除此之外,作者也发现,如果将对抗样本加入到训练集中,可以提高模型对对抗样本的防御能力,这是对抗训练的雏形。L-BFGS-B 作为最早期的对抗样本生成手段,启发了大量后续基于约束优化的对抗攻击方法。
Note:
关于优化问题和凸性有一个非常好的 教程 可以参考。
关于拟牛顿法计算的更多细节请参考刘浩洋等人编著的《最优化:建模、算法与理论》。
快速梯度符号法(FGSM)
2013 年,Szegedy 等人在研究神经网络的可解释性时,发现对于一些图像分类模型,甚至是当时的 SOTA 模型,只需要在图像上叠加一层精心构造的、人眼几乎无法察觉的微小扰动,原本正确分类的神经网络便会以极高的置信度给出完全错误的预测,他们将这类样本称为对抗样本(Adversarial Examples) (Christian Szegedy et al., 2014)。论文还观察到两个重要现象:其一,对抗样本具有迁移性——同一个对抗样本往往能让基于不同架构、甚至在不同数据子集上训练的模型同时误分类;其二,将对抗样本加入训练集可以提升模型抵抗攻击的能力,这基本就是对抗训练的雏形。此外,论文还指出网络的语义信息并非由单个神经元承载,而是分布在整个激活空间中,这也符合今天对神经网络的基本直觉。
2015 年,Goodfellow 等人针对 Szegedy 的发现,对对抗样本的存在给出了另一种解释 (Ian J. Goodfellow et al., 2015)。Szegedy 等人将对抗样本归因于深度网络的极端非线性和不连续性,认为输入空间里面散布着概率极低的“对抗口袋”。Goodfellow 等人则认为这解释不了对抗样本的跨模型甚至跨训练集的迁移性现象,因为如果这些对抗样本是过拟合或者非线性导致的随机产物,那就不可能跨模型、跨数据集复用。相反,他们认为,对抗样本的存在恰恰是因为模型太过于线性,因此高维空间中每个维度上的微小扰动会线性积累,从而将模型的输出 logits 推出决策边界。也就是说即便输入存在微小的变动也会对输出产生巨大的差异。论文基于这个解释提出了 Fast Gradient Sign Method (FGSM) 攻击方法。
对抗样本生成
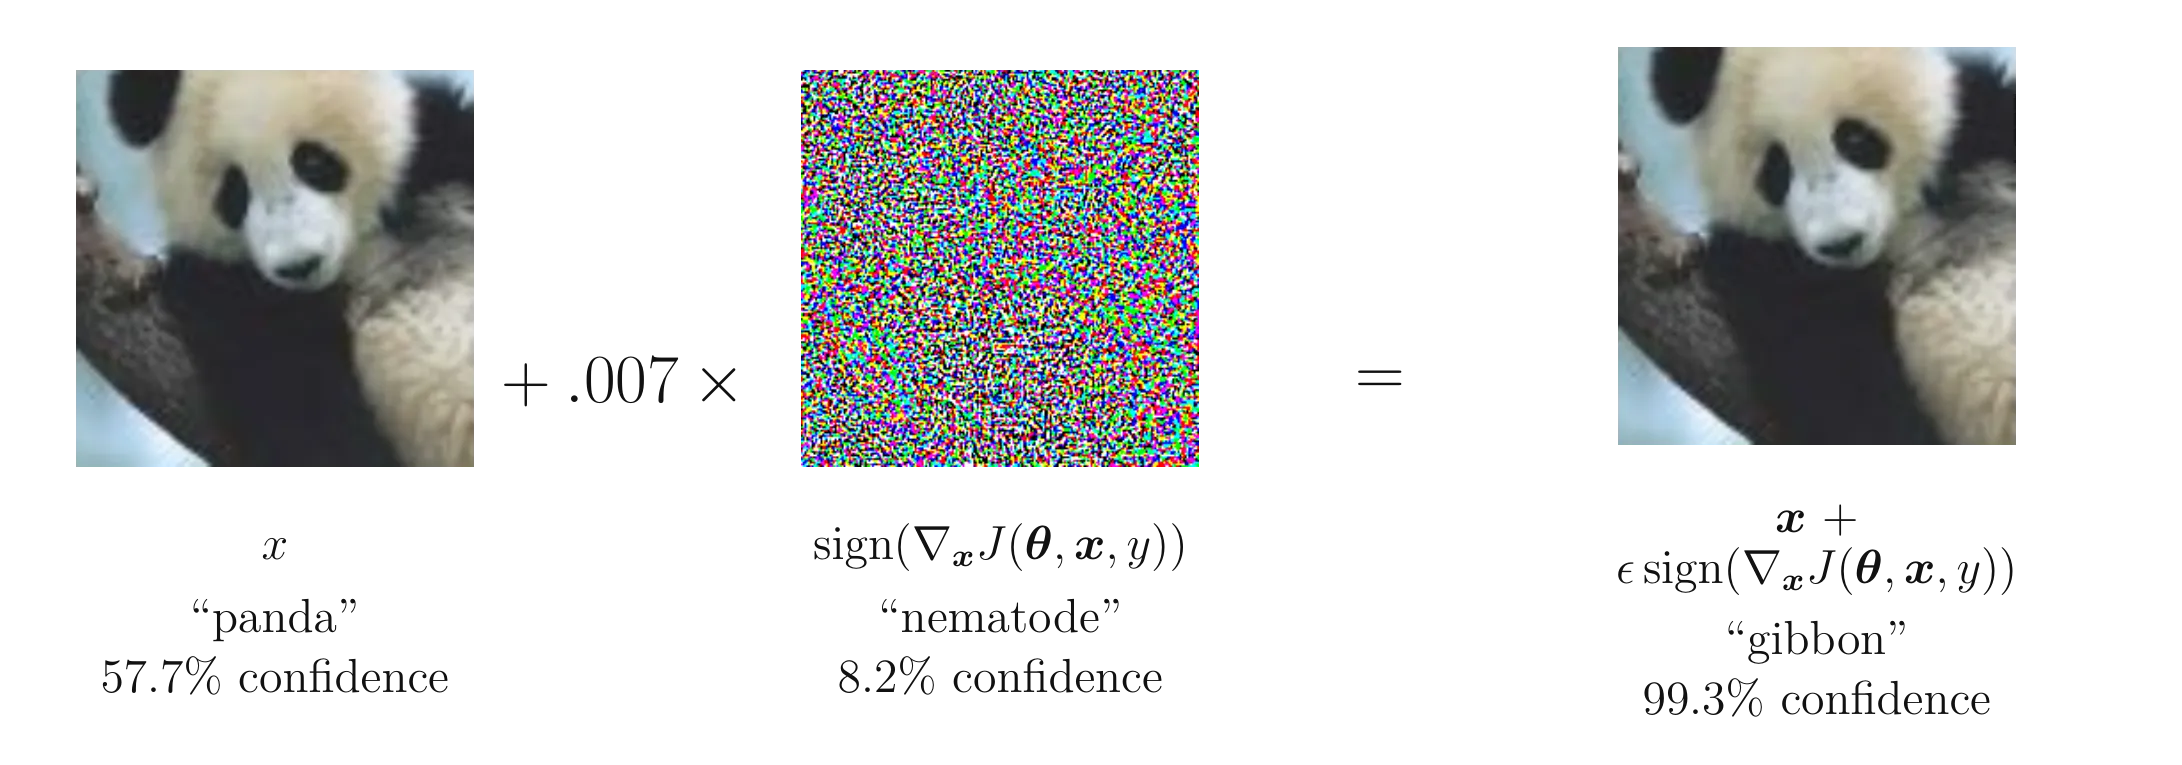
对于一个给定分类器 $f(\theta; x, y)$,其中 $x \in \mathbb{R}^d$ 是分类器输入,$y$ 为输出标签,$\theta$ 为分类器参数,定义其分类损失函数为 $\mathcal{L}(\theta; x, y)$。FGSM 通过对输入 $x$ 施加扰动 $\eta \in \mathbb{R}^d$,并将其约束在 $L_\infty$ 范数球中, 即 $\|\eta\|_\infty \le \epsilon$。对于对抗样本,要使得其产生的扰动最大,则需要对优化问题: $$ \max_{\|\eta\|_\infty \le \epsilon} \mathcal{L}(\theta; x + \eta, y) $$
进行求解。这个优化问题一般是非凸的,无法精确求解。(Ian J. Goodfellow et al., 2015) 的思路是,在当前样本点用一阶泰勒展开将非线性目标局部线性化,得到一个可以解析的局部线性近似:
$$ \mathcal{L}(\theta; x + \eta, y) \approx \mathcal{L}(\theta; x, y) + \eta^\top \nabla_x \mathcal{L}(\theta; x, y)\;, $$
因此约束优化问题转为:
$$ \max_{\|\eta\|_\infty \le \epsilon} \eta^\top \nabla_x \mathcal{L}\;, $$
该线性函数在 $L_\infty$ 上当 $\eta = \epsilon \text{sign}(\nabla_x \mathcal{L})$ 时有解析解。通过对输入进行一次反向传播即可获取梯度,进而计算得到扰动幅度大小,然后将其施加到输入图像 $x$ 上,注意对输入图像的边界进行控制:
def fgsm_attack(image, epsilon, data_grad):
    perturbed_image = image + epsilon * data_grad.sign()

    # 施加扰动后需要对对抗样本进行钳制到 [0, 1] 范围。
    return torch.clamp(perturbed_image, 0, 1)
对交叉熵损失函数进行反向传播计算关于输入的梯度:
import torch
import torch.nn.functional as F
from torchvision import transforms
import tqdm

device = torch.accelerator.current_accelerator().type \
        if torch.accelerator.is_available() else 'cpu'

def evaluate_fgsm(model, test_loader, device):
    model.eval()
    total = 0
    clean_correct = 0
    adversarial_correct = {epsilon: 0 for epsilon in epsilons}
    attack_successes = {epsilon: 0 for epsilon in epsilons}
    examples = {epsilon: [] for epsilon in epsilons}

    progress = tqdm.tqdm(test_loader, desc="Evaluating FGSM")

    for data, target in progress:
        data = data.to(device)
        target = target.to(device)

        # 设置输入数据为计算图叶子节点
        data.requires_grad_(True)

        # 基线
        clean_output = model(data)
        clean_pred = clean_output.argmax(dim=1)
        clean_match = clean_pred.eq(target)

        # 反向传播计算关于输入的梯度,对交叉熵损失进行梯度计算
        model.zero_grad(set_to_none=True)
        loss = F.nll_loss(clean_output, target) # https://github.com/pytorch/examples/blob/acc295dc7b90714f1bf47f06004fc19a7fe235c4/mnist/main.py#L10
        loss.backward()

        # 获取关于输入的梯度
        data_grad = data.grad
        raw_images = denormalize(data)

        total += target.numel()
        clean_correct += clean_match.sum().item()

        for epsilon in epsilons:
            if epsilon == 0:
                adversarial_images = raw_images.detach()
                adversarial_pred = clean_pred
            else:
                # 计算对抗样本
                adversarial_images = fgsm_attack(
                    raw_images,
                    epsilon,
                    data_grad,
                )
                with torch.no_grad():
                    adversarial_output = model(normalize(adversarial_images))
                adversarial_pred = adversarial_output.argmax(dim=1)

            adversarial_match = adversarial_pred.eq(target)
            adversarial_correct[epsilon] += adversarial_match.sum().item()
            attack_successes[epsilon] += (
                clean_match & ~adversarial_match
            ).sum().item()

            missing_examples = examples_per_epsilon - len(examples[epsilon])
            if missing_examples > 0:
                count = min(missing_examples, data.size(0))
                for index in range(count):
                    examples[epsilon].append({
                        "image": adversarial_images[index].detach().cpu(),
                        "true_label": target[index].item(),
                        "clean_pred": clean_pred[index].item(),
                        "adversarial_pred": adversarial_pred[index].item(),
                    })

    clean_accuracy = clean_correct / total
    adversarial_accuracies = [
        adversarial_correct[epsilon] / total
        for epsilon in epsilons
    ]
    attack_success_rates = [
        attack_successes[epsilon] / clean_correct if clean_correct else 0.0
        for epsilon in epsilons
    ]

    return clean_accuracy, adversarial_accuracies, attack_success_rates, examples
线性化失效的情况
原损失函数泰勒展开后的一阶近似的误差是 $\mathcal{O}(\|\eta\|^2)$,随着扰动幅度的平方而增长。对于输入样本领域,也就是当 $\epsilon$ 较小时,真实损失曲面在邻域内接近平面,FGSM 的扰动方向接近梯度方向,此时扰动效果较好,但是随着 $\epsilon$ 增大到一定程度,步长将超出线性化成立邻域。
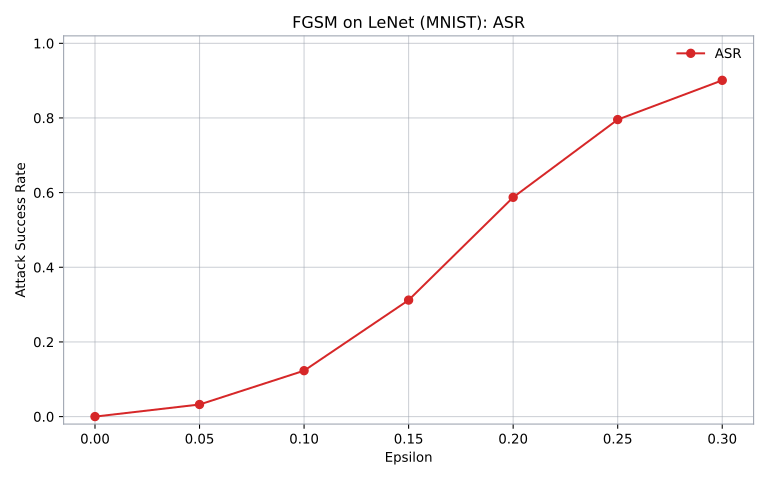
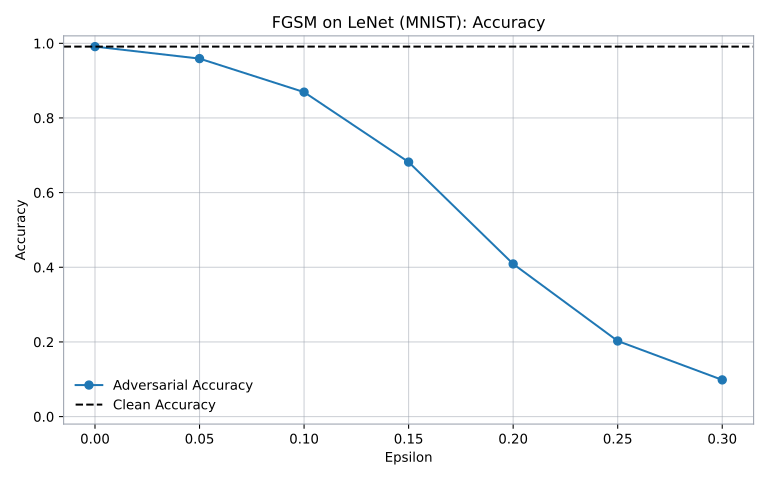
LeNet | MNIST 实验结果
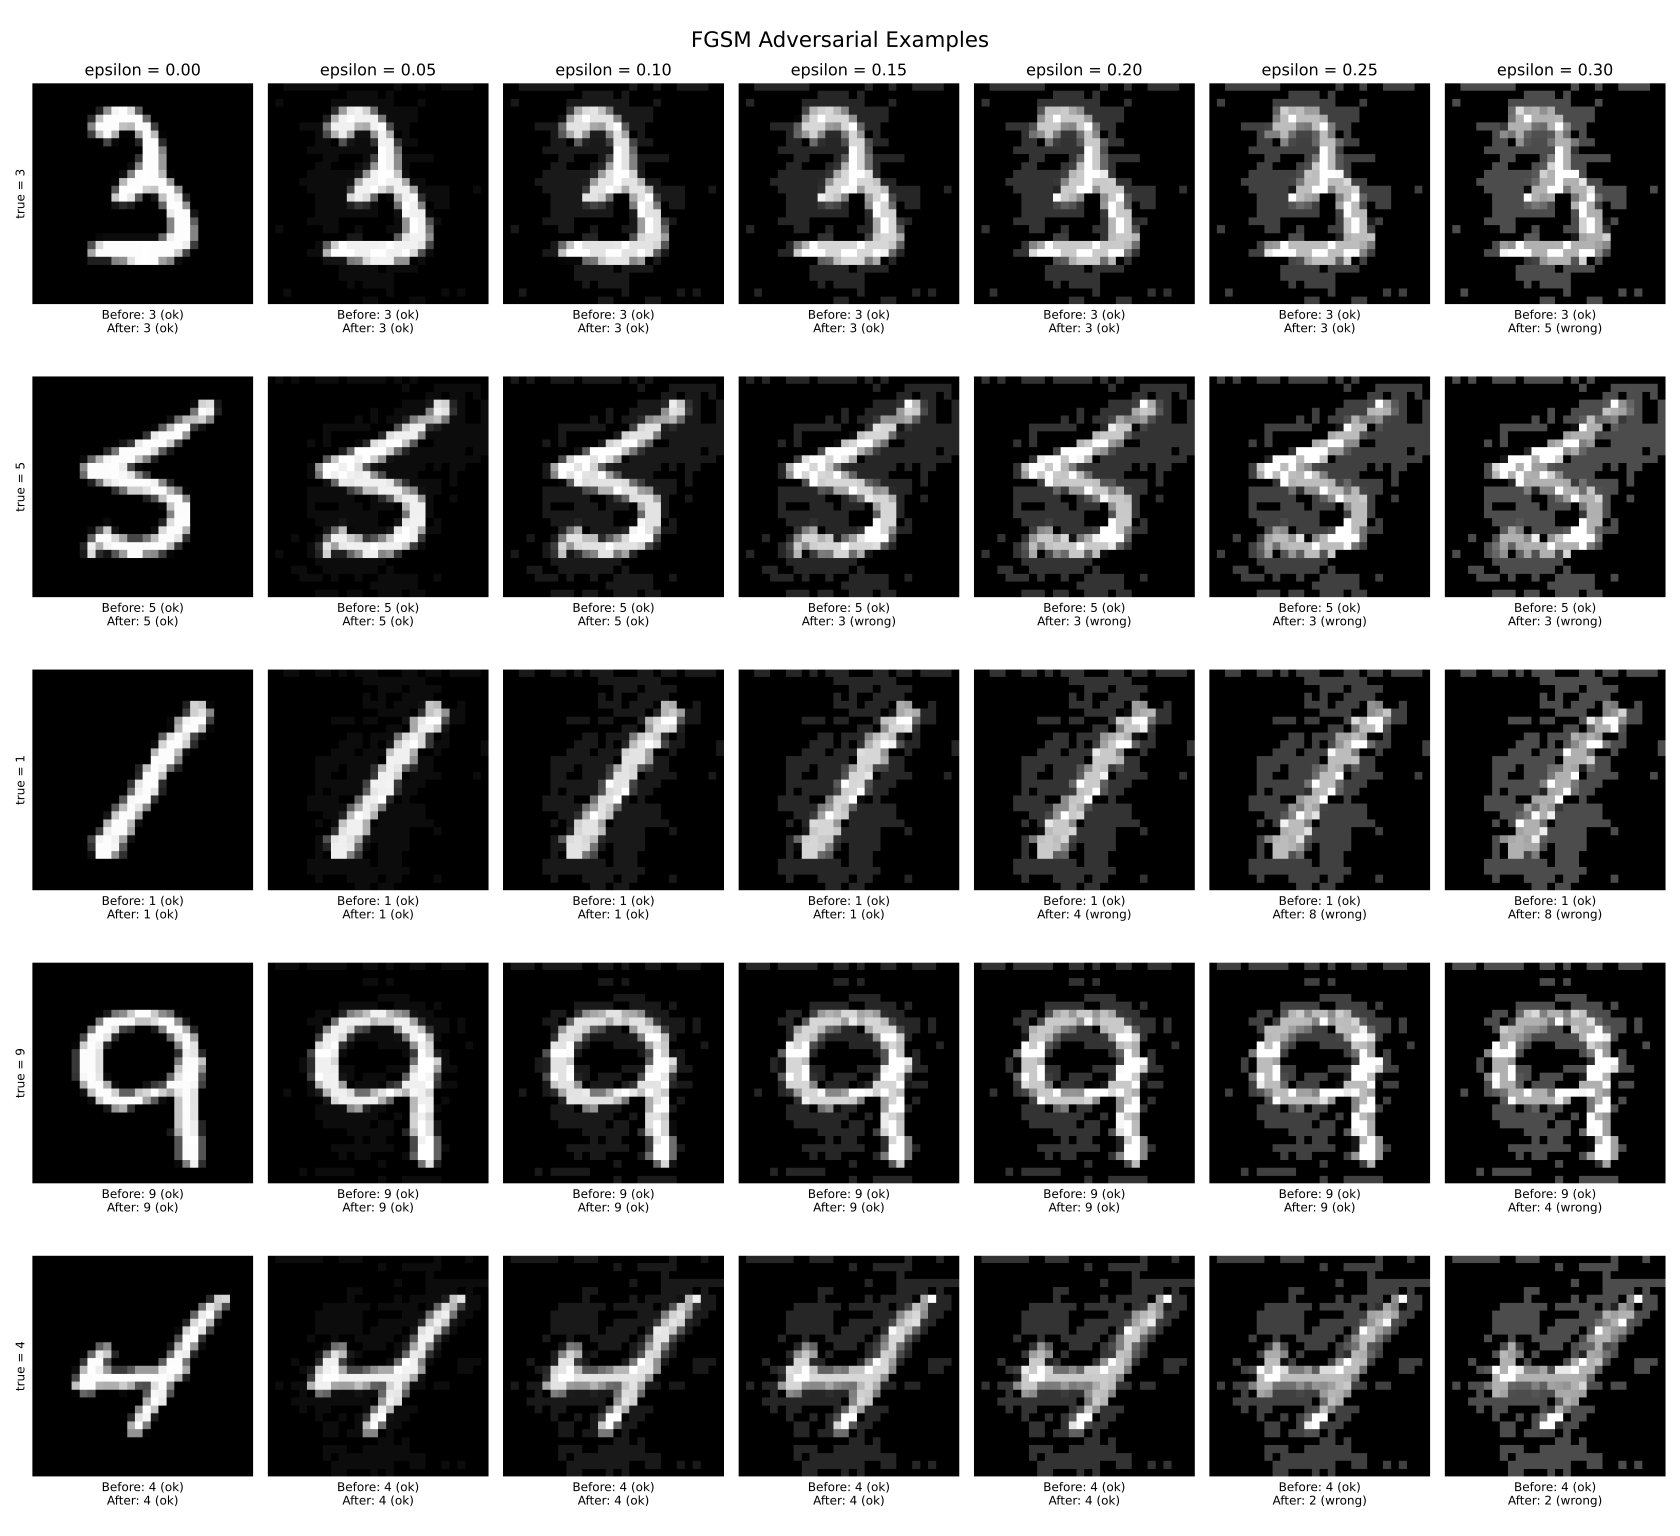
(venv) ai_sec/fgsm » python3 ./fgsm_impl.py
Using device: mps
Evaluating FGSM: 100%|█████████████████████████████████████████████████████████████████| 157/157 [00:14<00:00, 11.20it/s]
Clean Accuracy: 0.9911
epsilon=0.00 | Adversarial Accuracy=0.9911 | ASR=0.0000
epsilon=0.05 | Adversarial Accuracy=0.9590 | ASR=0.0324
epsilon=0.10 | Adversarial Accuracy=0.8692 | ASR=0.1230
epsilon=0.15 | Adversarial Accuracy=0.6818 | ASR=0.3121
epsilon=0.20 | Adversarial Accuracy=0.4089 | ASR=0.5874
epsilon=0.25 | Adversarial Accuracy=0.2025 | ASR=0.7957
epsilon=0.30 | Adversarial Accuracy=0.0983 | ASR=0.9008
实验结果验证了 Goodfellow 等人的线性化解释,随着扰动幅度 $\epsilon$ 增大,模型在对抗样本上的准确率也相对应地下降,当 $\epsilon$ = 0.3 时,模型分类准确率已经降到 10% 以下,不过图像的扰动也变得更加容易察觉。
CLIP | CIFAR-100 实验结果
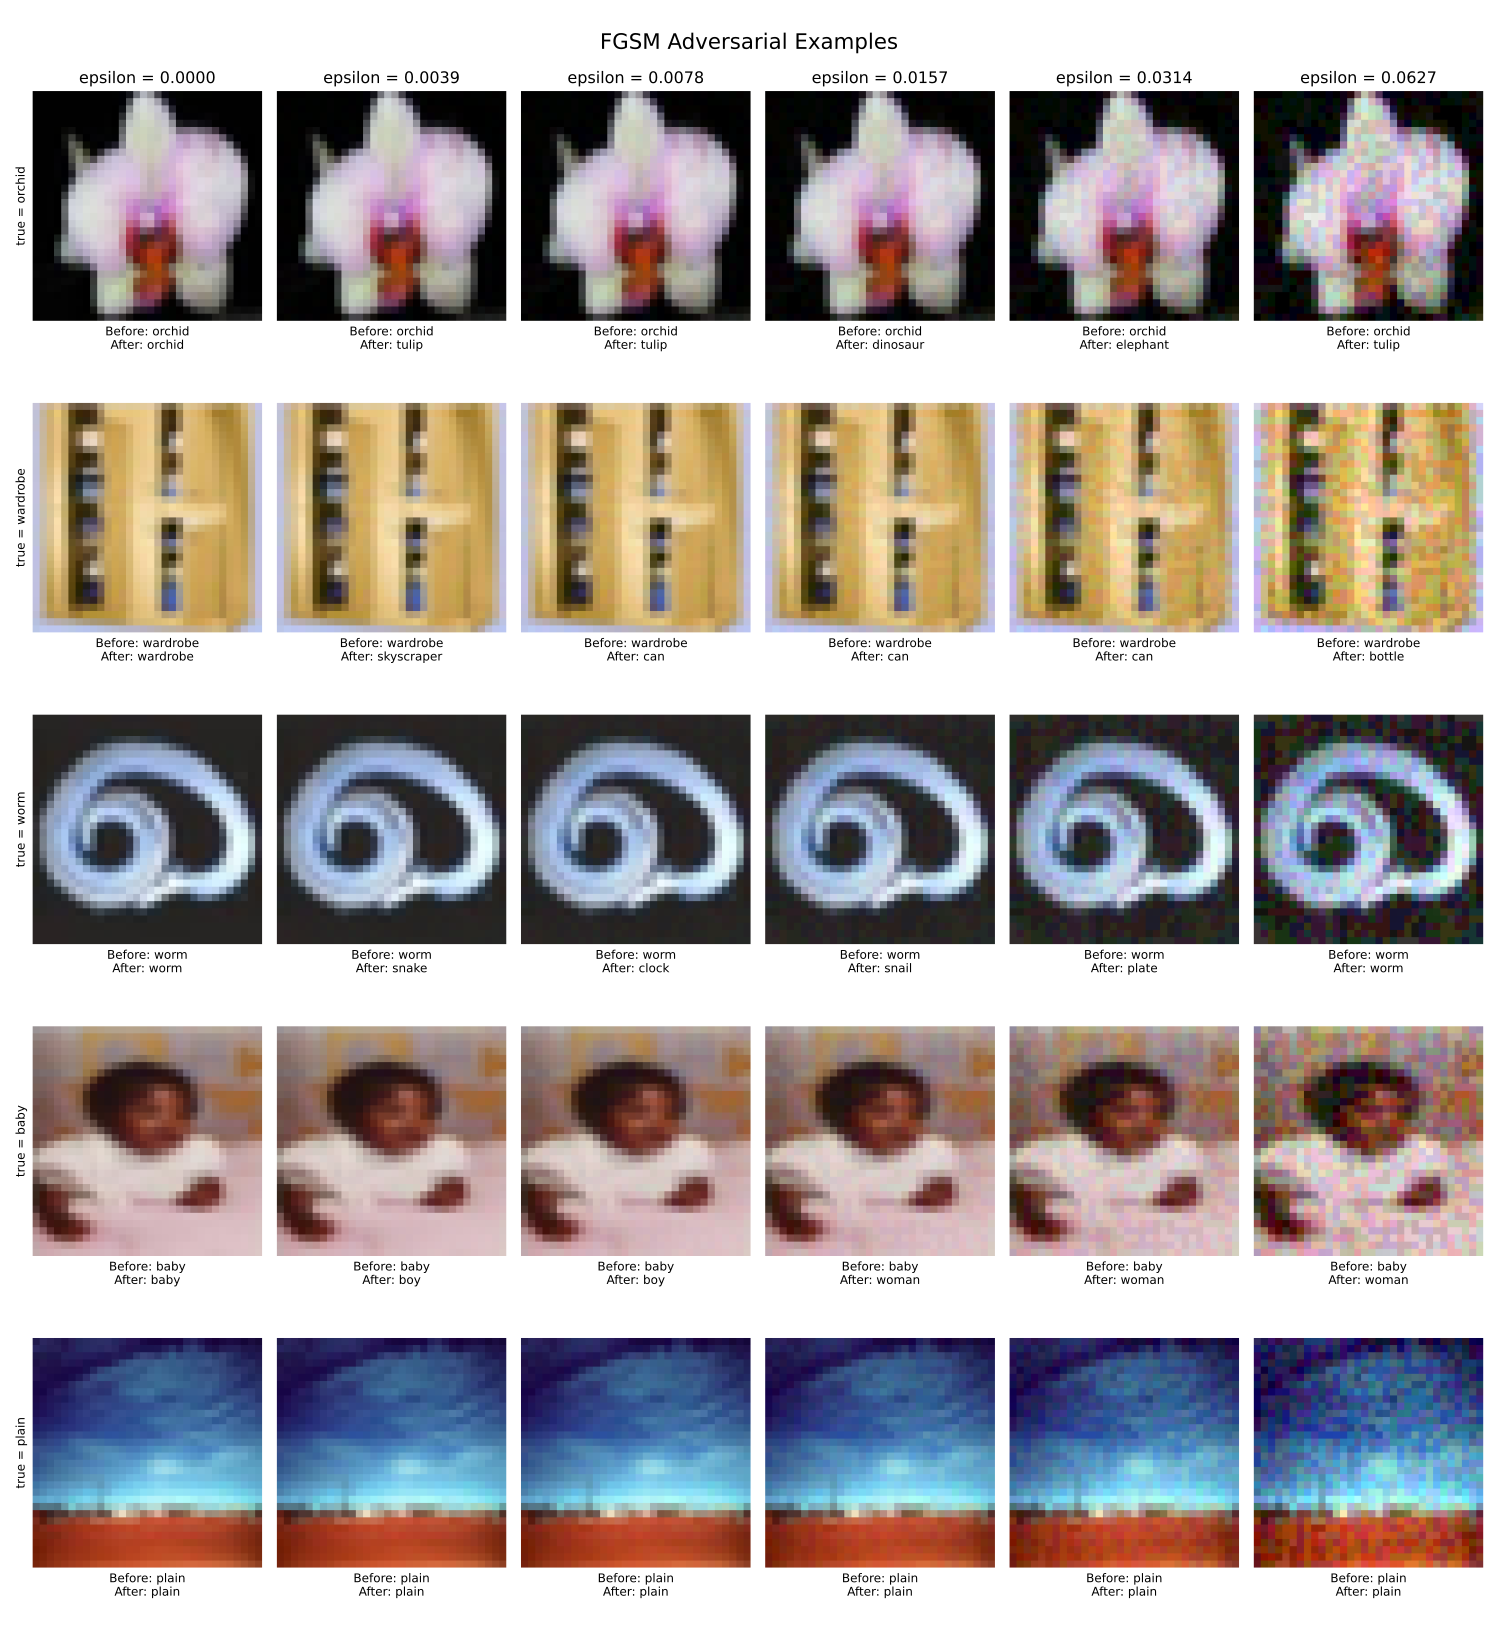
除了基线的 LeNet/MNIST,我还使用 CLIP (Alec Radford et al., 2021) 跑了一遍实验,在 GPT 的帮助下,使用 openai/clip-vit-base-patch32 进行 zero-shot 分类。label 是直接将 CIFAR-100 的 100 个类名填入到 “a photo of {class}” 的模板,然后用文本编码器编码得到 L2 归一化后的特征,图片则是将 32 $\times$ 32 的原始图像使用双线性插值法上采样到 224 $\times$ 224,归一化后送入图像编码器,再进行 L2 归一化。梯度是通过 100 个分类的 logits 的交叉熵损失关于原始 32 $\times$ 32 输入的梯度,logits 由图像特征与文本特征计算余弦相似度,再乘以一个可学习温度系数构成。CLIP 对超采样的图像的基线分类准确率达到 61.2%,还是挺不错的。
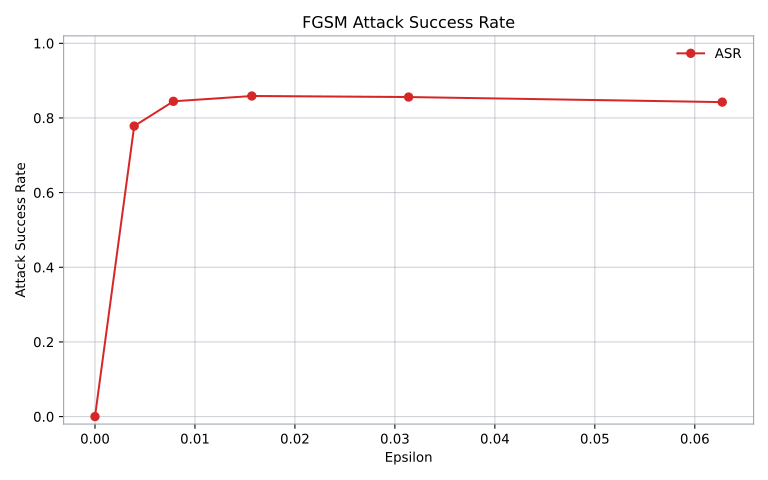
对于 CLIP,相同攻击效果下施加扰动的约束 $\epsilon$ 的量级远远小于 LeNet | MNIST 实验,在 (Ian J. Goodfellow et al., 2015) 中的线性解释中提到,输入维度越高,$\eta^\top\nabla_x \mathcal{L}$ 线性积累越强。此外,观察实验结果:随着 $\epsilon$ 增加,ASR 先升后平缓有降,ACC 也相对应的先极速下降然后稍反弹。这应该可以说明此时的攻击趋近饱和,或者说扰动在 $x$ 的小邻域内有效,当 $\epsilon$ 过大的时候,会超出损失上升最快的边界。
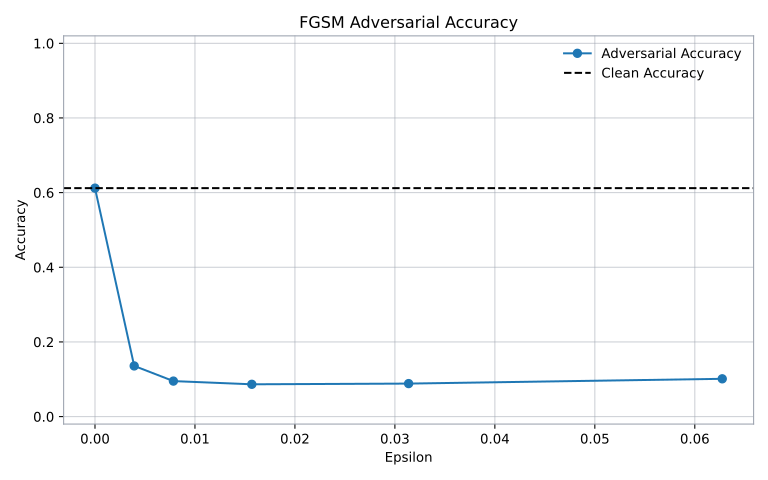
root@autodl-container-stz1h5y5jx-61b23d4b:~/autodl-tmp# python3 ./clip_cifar100_fgsm.py
Using device: cuda
Cache dir: /root/autodl-tmp/mount
Loading weights: 100%|██████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 398/398 [00:00<00:00, 32650.07it/s]
Evaluating FGSM (CLIP/CIFAR-100): 100%|████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 157/157 [00:50<00:00,  3.13it/s]
Clean Accuracy: 0.6120
epsilon=0.0000 | Adv Acc=0.6120 | ASR=0.0000
epsilon=0.0039 | Adv Acc=0.1357 | ASR=0.7783
epsilon=0.0078 | Adv Acc=0.0951 | ASR=0.8446
epsilon=0.0157 | Adv Acc=0.0865 | ASR=0.8588
epsilon=0.0314 | Adv Acc=0.0884 | ASR=0.8560
epsilon=0.0627 | Adv Acc=0.1012 | ASR=0.8425
FGSM 的攻击脆弱性来源
在做 LeNet/MNIST 和 CLIP/CIFAR-100 两个实验的过程中,不难看到要产生显著攻击效果,两个实验需要进行的扰动是不同的。例如,对于 LeNet/MNIST,要使模型的 Acc 降低到 40% 以下,需要施加扰动 $\epsilon > 0.20$,而相同的目标下,CLIP/CIFAR-100 仅需要施加扰动 $\epsilon < 0.004$ 即可将 Acc 降低到 15% 以下。但是,之所以 CLIP 模型相较于 LeNet 如此脆弱,是由于模型参数量更大导致,还是由于输入图像数据维度过高导致的?
对 CLIP 模型进行冻结,对输入图像采用不同方式进行梯度计算和扰动:
- 对 CIFAR-100 的 32 $\times$ 32 原图扰动;
- 对上采样后的图像(224 $\times$ 224)进行扰动;
- 对原图进行扰动梯度的计算,然后将其复制到上采样图像的 7 $\times$ 7 个区块施加扰动。
Clean acc = 0.612 (n = 10,000):
| $\epsilon$ ($\times$ 1/255) | ASR (3,072 dims) (%) | ASR (150,528 dims) (%) | ASR (梯度平铺到 7 $\times$ 7,150,528 dims) (%) |
|---|---|---|---|
| 0.125 | 21.5 | 56.5 | 28.6 |
| 0.25 | 38.8 | 64.7 | 45.4 |
| 0.5 | 59.4 | 77.1 | 60.9 |
| 1 | 76.3 | 83.9 | 73.0 |
| 2 | 82.8 | 86.4 | 77.8 |
| 4 | 84.8 | 86.4 | 77.2 |
| 8 | 83.3 | 86.5 | 75.0 |
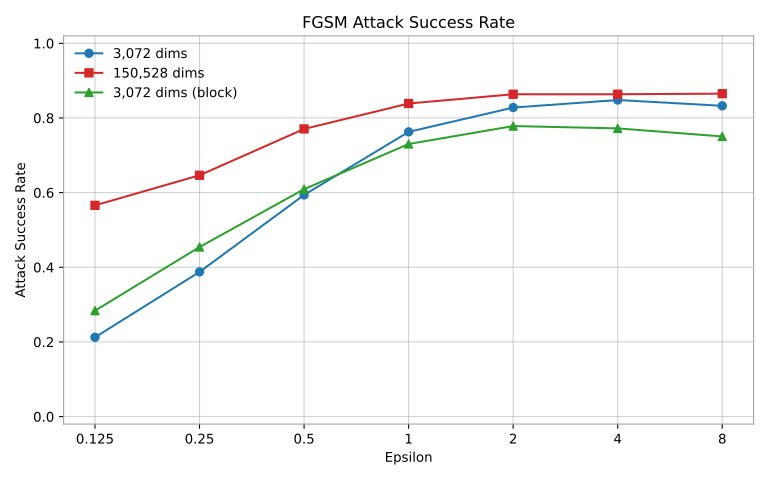
从实验结果上看针对上采样图片进行扰动的攻击成功率显著高于另外两类扰动攻击,整体上图像左移。在 $\epsilon = 0.125/255$ 时,针对上采样图像扰动的 ASR 已经达到 56.5%,远远高于基线 21.5%。这说明针对相同模型和样本,扰动空间的维度对于对抗攻击效果有显著影响,可以证明线性解释的合理性。
对于第 3 种扰动方式,其实际扰动像素同第 2 类相同,均为 224 $\times$ 224,但是对上采样图像分块分别共享同一个扰动值,独立自由度为 3,072。实验结果显示 1、3 的攻击效果存在一致性,据此初步可以判断决定扰动效果的是梯度,而不是扰动像素的量的大小。
线性解释
(Ian J. Goodfellow et al., 2015) 用线性解释分析了对输入进行微小扰动会导致输出偏移的原因。考虑权重向量 $\mathbf{w}$ 和对抗样本 $x_\text{adv} = x_\text{clean} + \delta$ 的点积:
$$ \mathbf{w}^\top x_\text{adv} = \mathbf{w}^\top x_\text{clean} + \mathbf{w}^\top \delta $$
其中 $x, \delta \in \mathbb{R}^d$。对抗扰动会以 $\mathbf{w}^\top \delta$ 的程度增加,从形式上看,对于输入维度较大的模型,施加微小扰动也会产生较高的线性积累,其最大值为 $\epsilon \|\mathbf{w}\|_1$。
设计一个实验使用余量逐个样本求解进行验证线性解释。首先对于 clean 分类正确的样本,定义模型输出 logits 余量如下:
$$ m(x) = z_y - \max_{k \ne y} z_k $$
其中 $z_y$ 表示正确样本分类所需要的 logits,$\max_{k \ne y} z_k$ 表示其余标签的最大 logits 输出。$\max_{k \ne y}{z_k} $ 不可微分,但基于 Danskin 定理,在实际计算过程中,考虑取 $k^\ast = \arg\max_{k \ne y} z_k(x)$ ,再对函数 $m(x) = z_y - z_{k^\ast}$ 求梯度。因此要求解的目标约束优化问题为:
$$ \min_{\|\delta\|_\infty \le \epsilon} m(x + \delta)\;, $$
在 clean 点附近对余量做一阶泰勒展开:
$$ m(x + \delta) \approx m(x) + \delta^\top \nabla_x m\;, $$
攻击者在扰动预算 $\|\delta\|_\infty \le \epsilon$ 内希望余量尽可能小,当 $\delta = -\epsilon \cdot \text{sign}(\nabla_x m)$ 时,此时取 $m$ 的负梯度方向进行扰动,余量取到最小:
$$ \min_{\|\delta\|_\infty \le \epsilon} m(x + \delta) \approx m(x) - \epsilon\,\|\nabla_x m\|_1\;, $$
令最坏情况下的余量为 0,可以反解出越过决策边界所需的临界扰动大小:
$$ \epsilon^\ast = \frac{m(\mathbf{x})}{\|\nabla_x m \|_1}\;. $$
从公式上看,影响单样本脆弱性的主要有两个因子。分子 $m$ 是决策余量,分母 $\|\nabla_x m\|_1$ 是余量梯度的 $L_1$ 范数。决策余量越小,模型越脆弱。而从余量梯度范数分析,若维度数增大,模型也会更加脆弱。
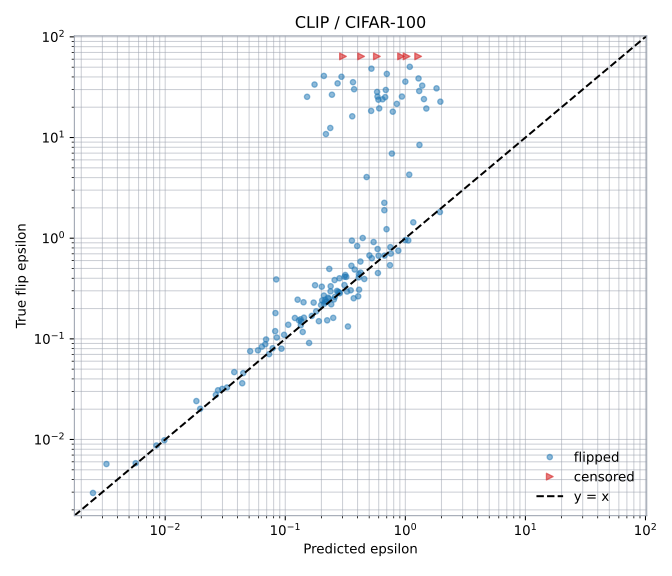
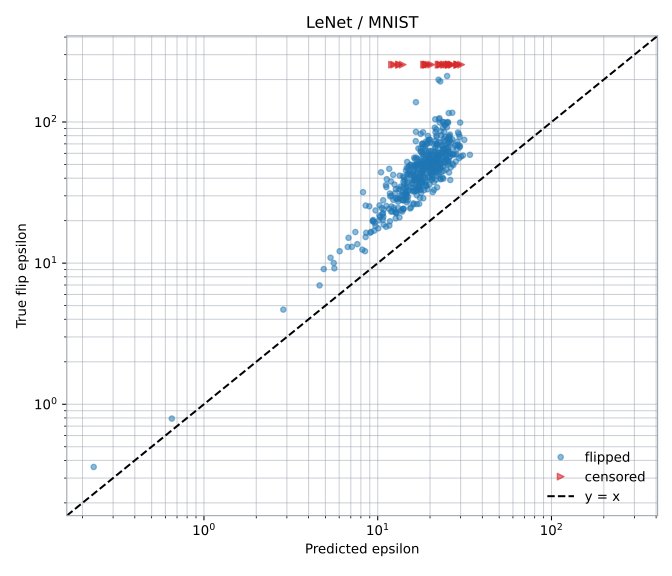
实验设置上,选择 CLIP/CIFAR-100 和 LeNet/MNIST 在全量图像上进行对抗扰动的线性查找。首先根据 (Ian J. Goodfellow et al., 2015) 的线性解释,使用上述余量计算公式对扰动余量进行预测 $\epsilon_\text{pred}$ ,对于实际扰动余量可以通过向量化二分搜索法沿着梯度方向在 $[0, 255]$ 上进行查找 $\epsilon \times 255$,记搜索结果为 $\epsilon_\text{flip}$,然后对两者进行相关性比较,得到如下结果。
| 模型 | $\log_r$ (全部) | $\log_r$ (小 $\epsilon$ 半区) | 半区拟合斜率 | $\epsilon_\text{flip}/\epsilon_\text{pred}$ 中位比 |
|---|---|---|---|---|
| CLIP/CIFAR-100 | 0.762 | 0.969 | 0.94 | 1.09 |
| LeNet/MNIST | 26 | 0.881 | 0.931 | 1.05 |
对于 CLIP 的小 $\epsilon$ 半区 $\log_r$ 达到 0.969,拟合斜率为 0.94,因此预测值和向量方向翻转点高度重合。这些样本本身离决策边界很近,因此线性近似后计算的预测余量能够很好覆盖 clean 样本点到预测边界的路径。因此可以证明原论文的线性解释是合理且有效的。而对于全部 $\epsilon$ 区域样本的决策边界显著高于预测值,此时 $\log_r$ 为 0.762,这是因为对于高 $\epsilon$ 采用线性近似失效。这说明 FGSM 在一定程度上通过线性近似可以有效求解对抗样本,但是效果对于扰动余量较高的样本逐渐失效。
而对于 LeNet,其真实余量和预测值中位数比值为 2.10,但半区拟合斜率为 1.05,这是由于二分搜索基于输入梯度计算方向和余量梯度计算方向存在差异导致的。不过,通过上面的分析,也可以知道,仅对余量进行计算也可以实现 FGSM 类似效果。
结论
FGSM 通过牺牲了最小扰动来换取对抗样本生成速度,设置 $\epsilon$ 来固定化扰动的幅度,仅仅使用 $\text{sign}$ 来确定扰动的方向,仅仅只需要一次反向传播计算关于输入的梯度即可生成对抗样本,计算成本极低。FGSM 可以用于对抗训练样本的大规模快速生成,这是它的优势,而在攻击上相较于 L-BFGS-B 没有这么精细,攻击的效果有限,且扰动的特征更明显。
投影梯度下降(PGD)
(Aleksander Madry et al., 2019) 在论文开头提出“如何训练出能够对对抗输入鲁棒的神经网络”:
How can we train deep neural networks that are robust to adversarial inputs?
并将鲁棒训练定义为一个鞍点(min-max)优化问题 (Abraham Wald, 1945):
$$ \min_\theta (\rho(\theta))\quad \text{where}\quad \rho(\theta) = \mathbb{E}_{(x, y) \sim \mathcal{D}} \left[\max_{\delta \in \mathcal{S}} \mathcal{L}(\theta; x + \delta, y)\right]\;, $$
其中 $\mathcal{D}$ 表示真实世界中数据的联合分布。这个公式可以看作两个部分:内层 $\max_{\delta \in \mathcal{S}}$(参考 FGSM)表示在允许的扰动集合 $\mathcal{S}$ 内找到让损失最大化的扰动,外层则通过调整模型参数 $\theta$,使得“对抗损失”的期望最小。这个问题是无法直接计算的,更不可能直接优化,因为我们不可能获取真实世界的所有样本,所以只能够使用训练样本进行训练。
FGSM 的 PGD 迭代变体
(Ian J. Goodfellow et al., 2015) 提出的 FGSM 是一个一阶优化求解的扰动生成方法,其生成一个 $L_\infty$ 约束的对抗扰动并计算对抗样本:
$$ x_\text{adv} = x + \epsilon \text{sign}(\nabla_x \mathcal{L}(\theta; x, y))\;, $$
FGSM 并不是一个精细的对抗样本生成器,而是非线性函数的一阶线性近似,因此可以使用一个多步的迭代变体,即 BIM(Alexey Kurakin et al., 2017),(Aleksander Madry et al., 2019) 在此基础上引入随机初始化,在 $x$ 附近的扰动球内均匀取一个起点,并将其确立为内层最大化问题的标准一阶求解器,即对负损失函数做投影梯度下降(PGD)进行优化:
$$ x^{t+1} = \prod_{x + \mathcal{S}}(x^t + \alpha \text{sign}(\nabla_x \mathcal{L}(\theta; x^t, y)))\;. $$
这里的投影 $\prod_{x+\mathcal{s}}$ 是很好算的,即将左边逐个坐标截断 $[x_i - \epsilon, x_i + \epsilon]$ 然后对像素进行 clamp 到合法范围。为了方便起见在这里留几个投影截断的例子。对于点 $z$,有:
| 可行域 | 投影公式 |
|---|---|
| $L_2$ 球 $||x||_2 \le r$ | $z \cdot \min\left(1, \frac{r}{||z||_2}\right)$ |
| $L_\infty$ 球 $||x||_\infty \le \epsilon$ | 截断到 $[-\epsilon, \epsilon]$ |
| 盒约束 $a_i \le x_i \le b_i$ | 直接截断到 $[a_i, b_i]$ |
PGD 迭代参数有两个,一个是步长 $\alpha$,一个是迭代次数 $T$。假设 $T$ = 1,步长取 $\alpha$ = $\epsilon$,从当前点 $x$ 直接出发:
$$ x_1 = \prod_{x+\mathcal{S}}(x + \epsilon \text{sign}(\nabla_x \mathcal{L}(\theta; x, y)))\;, $$
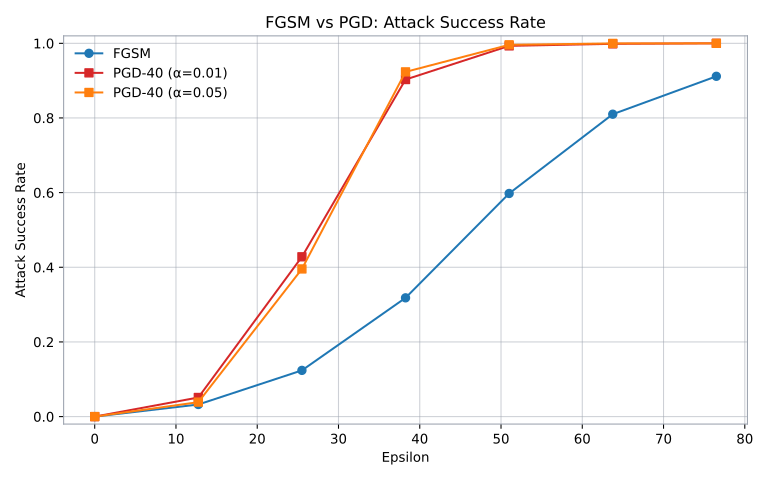
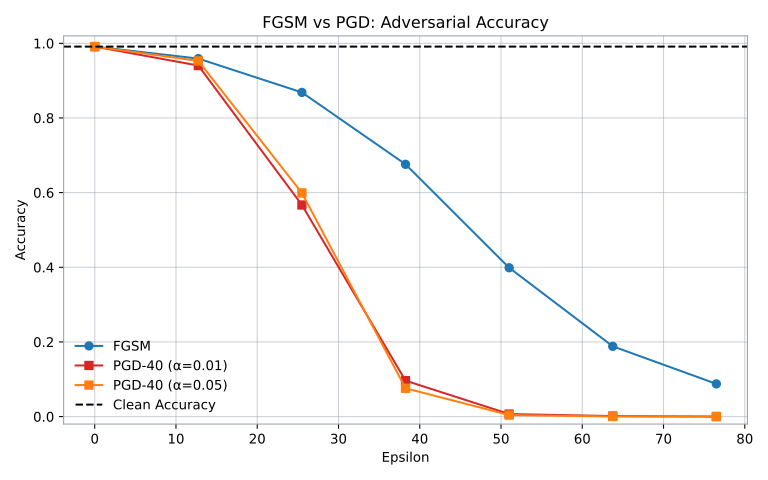
由于 $x + \epsilon \text{sign}(\nabla_x \mathcal{L})$ 的每个坐标恰好在 $L_\infty$ 边界上,此时 PGD 算法退化为 FGSM,因此 FGSM 实际上是 PGD 的一个特例。
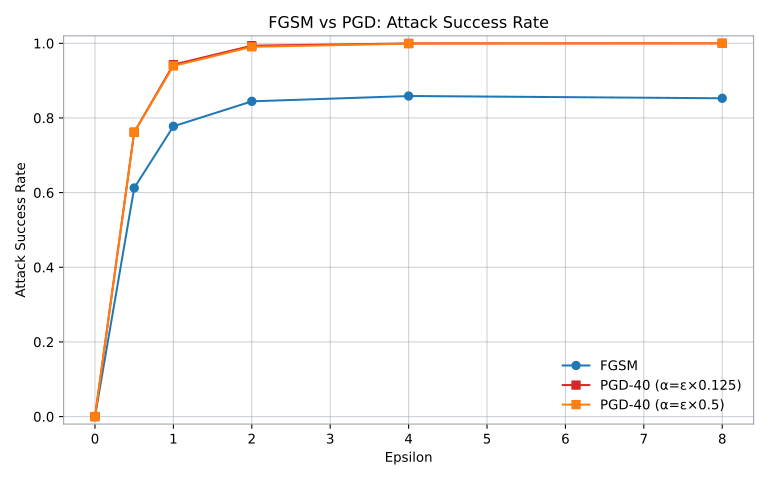
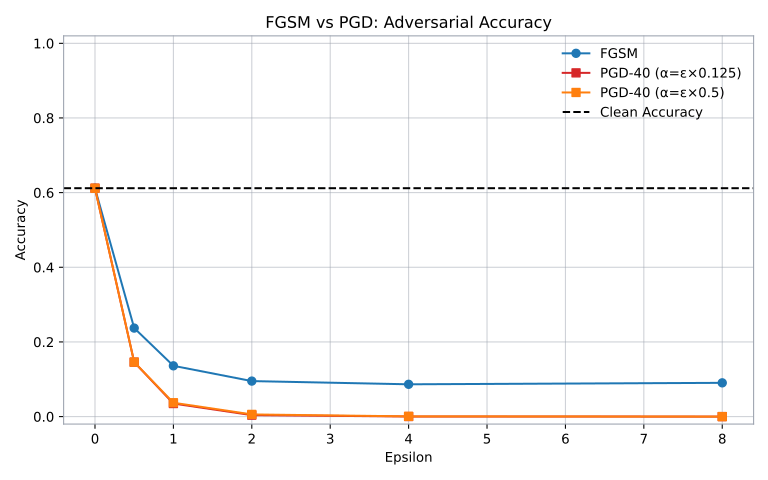
FGSM vs PGD
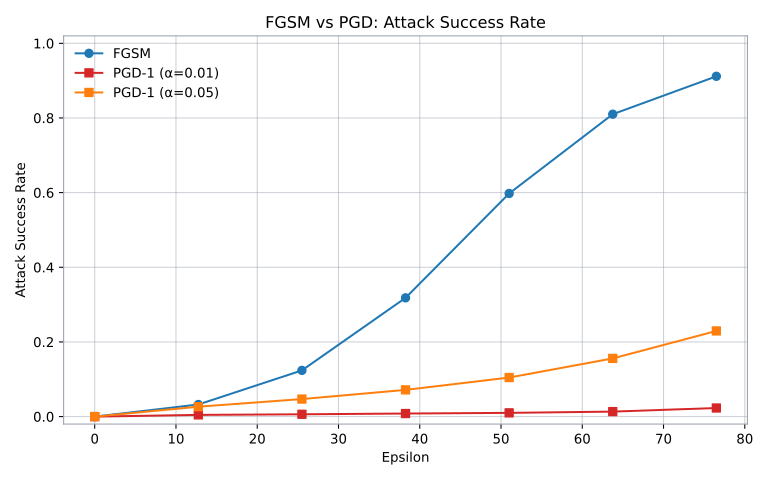
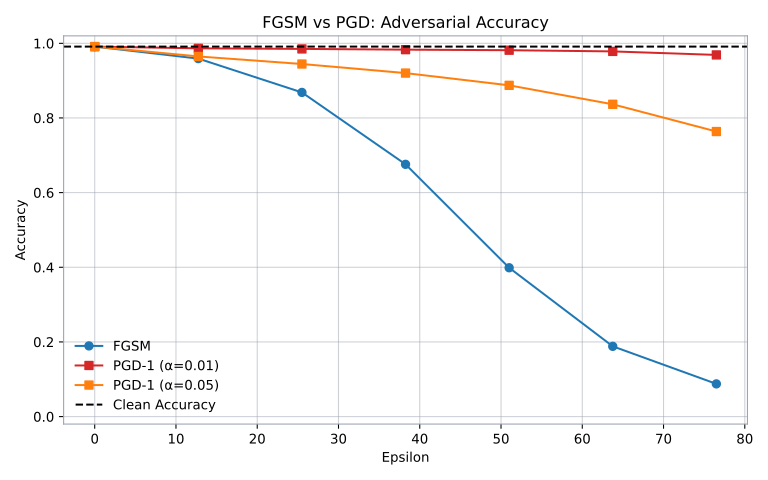
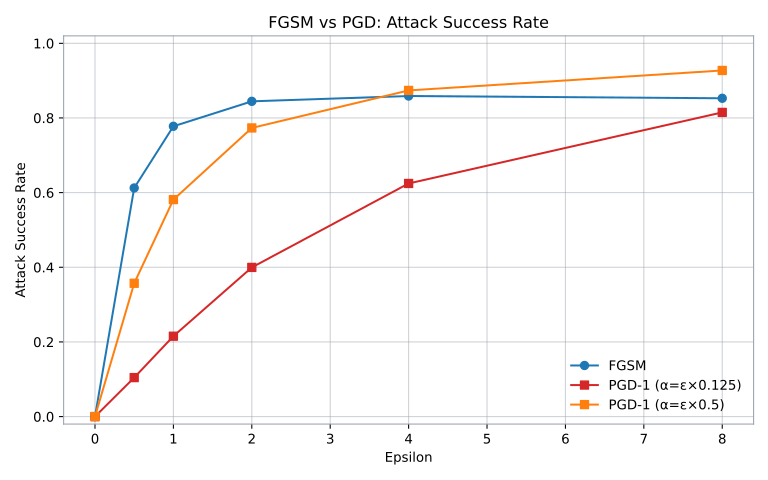
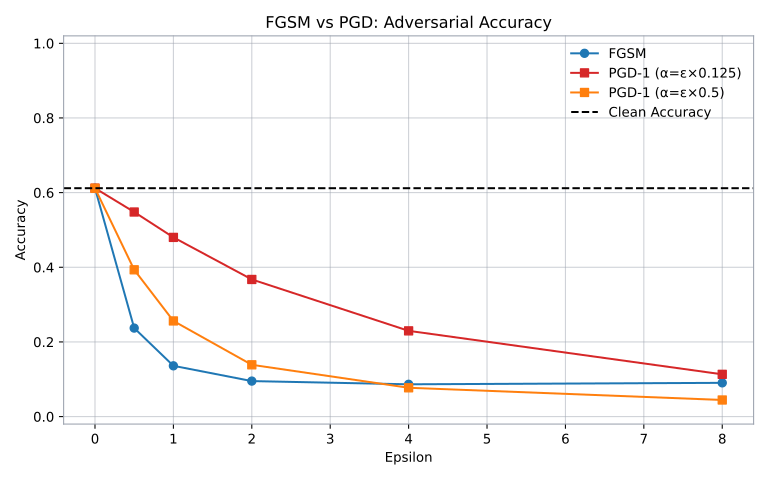
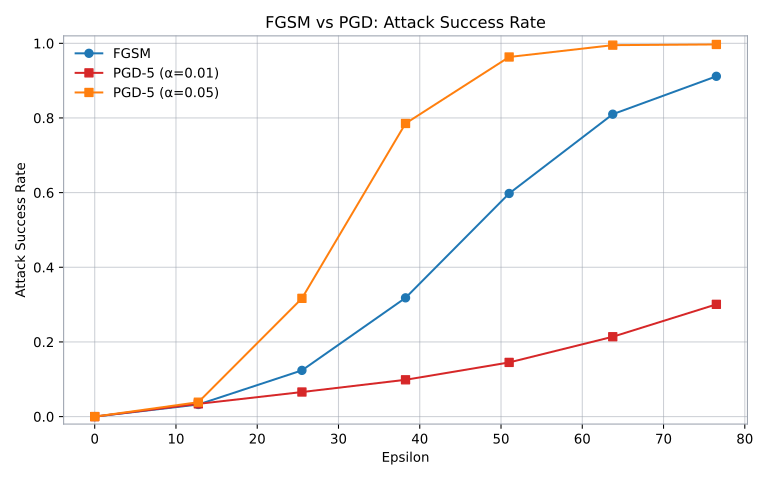
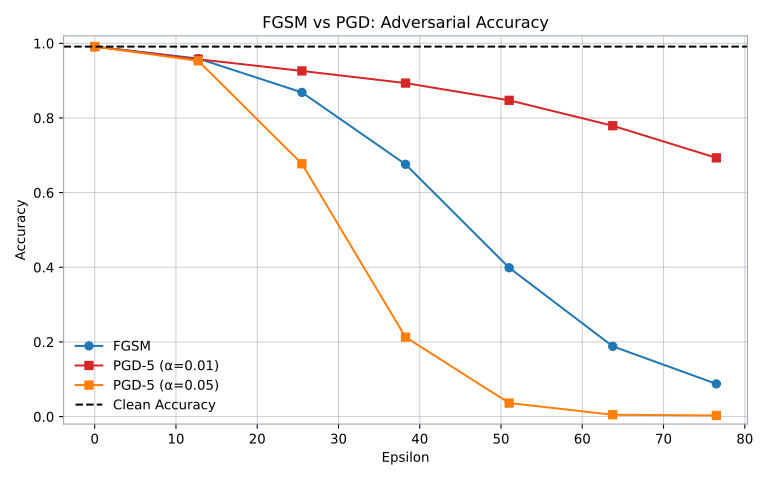
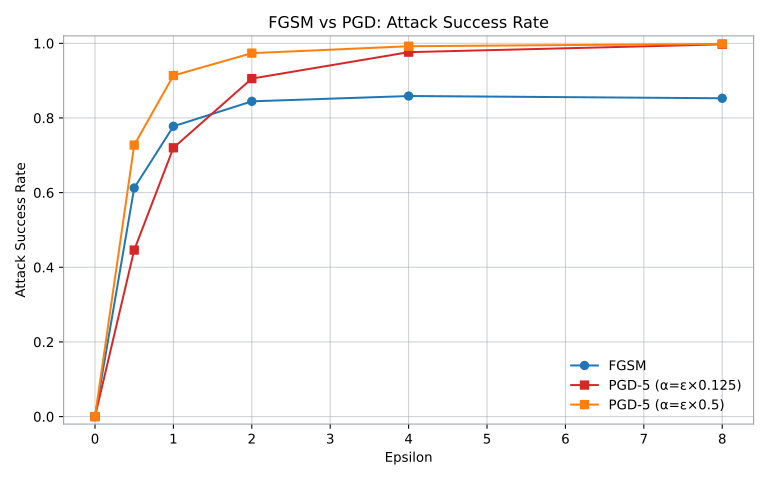
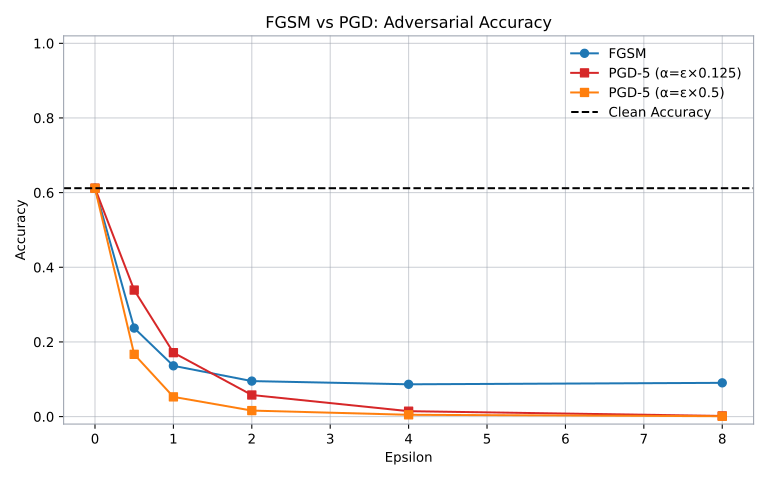
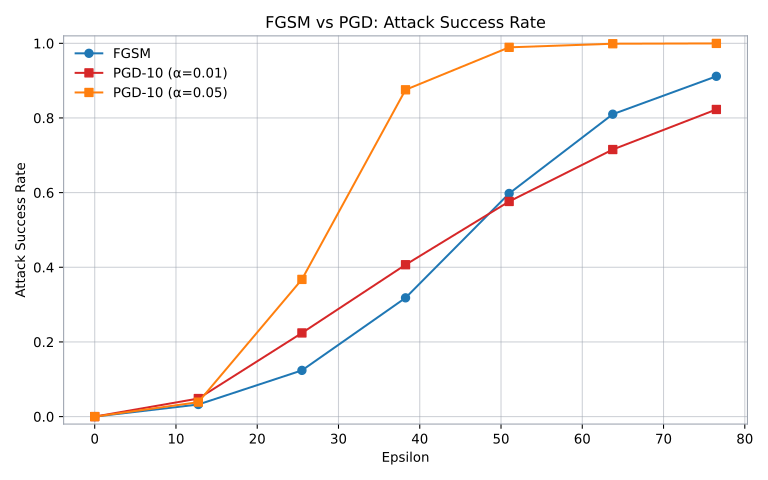
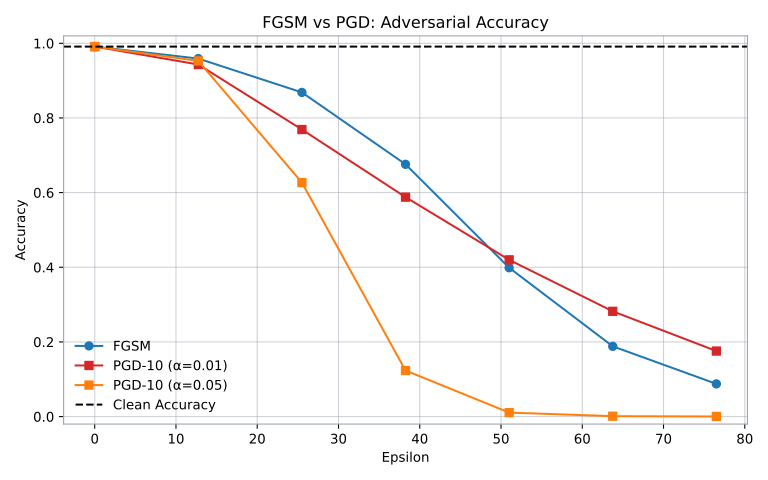
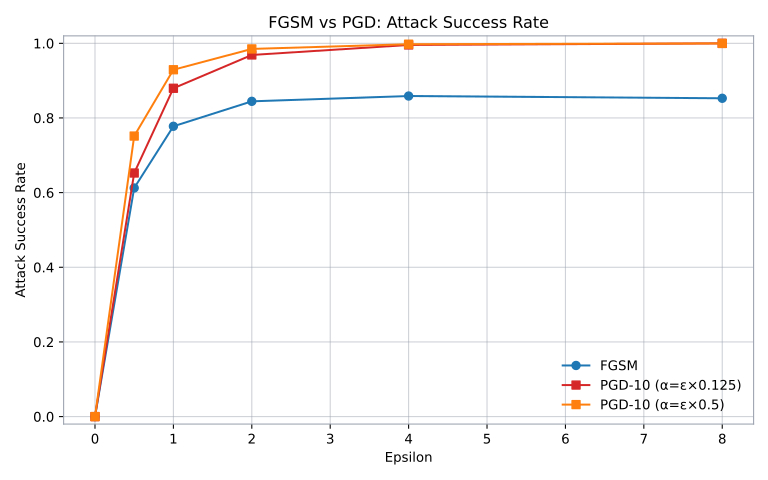
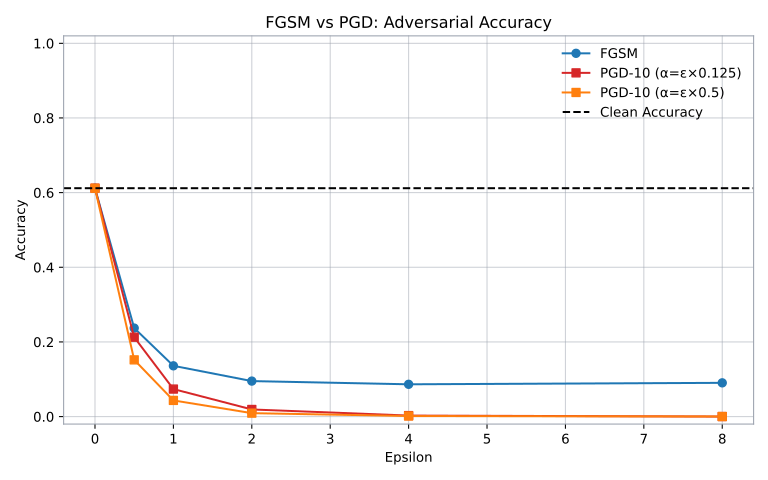
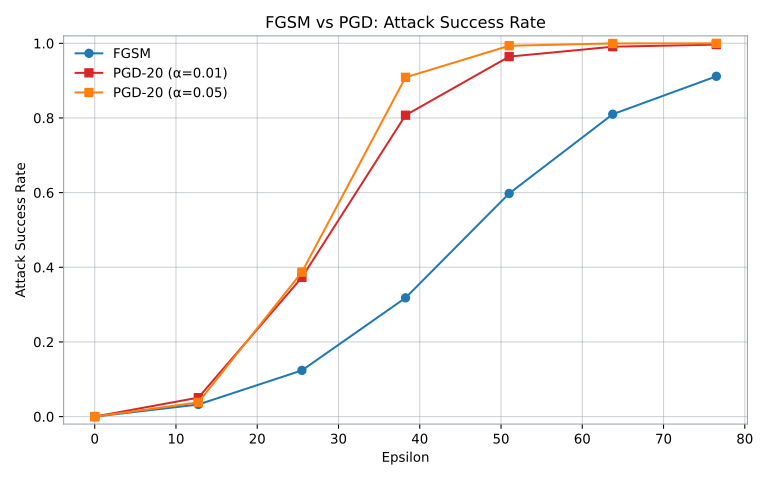
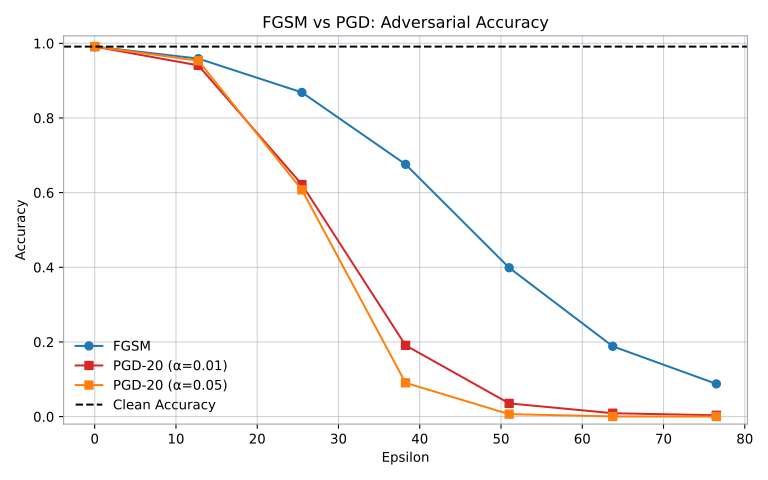
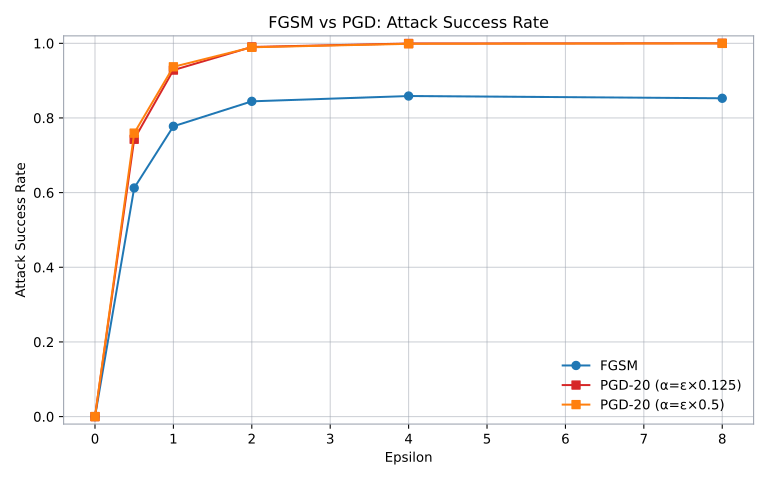
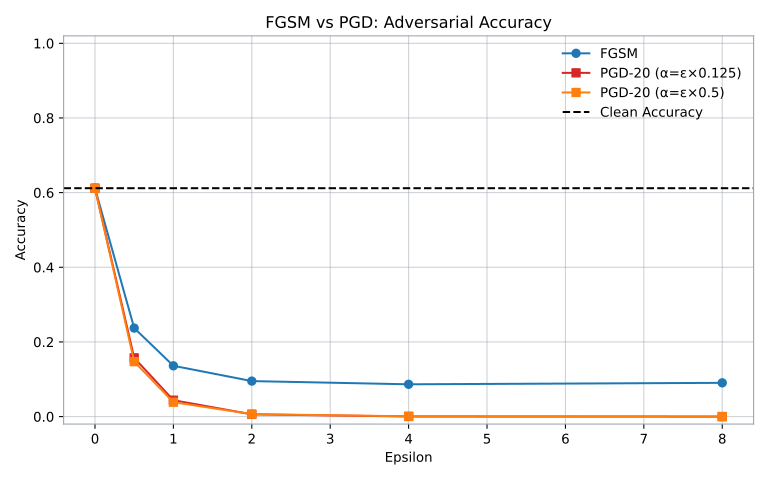
Carlini & Wagner(C&W)攻击
再回到 2013 年,(Christian Szegedy et al., 2014) 发现对抗样本之后,学术和社区便开始不断发展攻击和防御的方法,此时有大量的防御手段出现并声称有效 (Nicolas Papernot et al., 2016),但是绝大多数防御论文的评估手段使用的都是 FGSM,而 FGSM 并非是一个强攻击手段!为此,(Carlini & Wagner, 2017) 提出:评估一个防御的鲁棒性,必须要为该防御量身定做一套强攻击去检验,而不能够只使用现有的攻击手段。为了证明这一点,他们构造了一组当时最强的攻击。这篇论文也因此成为对抗样本防御评估方法论的奠基之作。
C&W 是基于优化的攻击方法,其一般扰动约束如下:
$$ \begin{aligned} \text{minimize}\; &\mathcal{D}(x, x + \delta) \\ \text{s.t.}\; &C(x + \delta) = t \\ &x + \delta \in [0, 1]^n \end{aligned} $$
其中 $x$ 是输入图像,目标是找到 $\delta$ 使得 $\mathcal{D}(x, x + \delta)$ 最小化。论文中对 $\mathcal{D}$ 的定义是扰动的度量,有三类:$L_0$、$L_2$ 或者 $L_\infty$。


 本文采用知识共享署名-非商业性使用 4.0 国际许可协议进行许可。This work is licensed under the Creative Commons Attribution-NonCommercial 4.0 International License.