杂谈:Linux 网络
Linux 内核网络功能实现基于 TCP/IP 协议栈的四层模型架构,通过对不同网络层,在分组发送方和接收方对网络数据包分别进行分层包装和逐层解包实现不同模型层面的通信。这种实现被称为 网络协议栈。如图是 Linux 网络通信的具体实现同 OSI 模型的关系,以及数据在用户空间、内核空间和物理链路的流通方向。
几个值得讨论的部分如下:
- Socket:是 Linux 开放给用户态程序的网络接口,用于用户程序和内核空间网络协议栈进行通信;
- TCP/IP:网络协议栈;
- Device:网络设备。这是Linux内核中对物理链路层设备的一种抽象,它是操作系统实现同物理设备通信的借口,其可能直接同真实物理硬件设备相关联,也有可能是一段程序(如虚拟网卡、TUN/TAP等)。Wireshark、tcpdump 等工具工作在该层;
- Driver:网卡驱动程序。对于接收数据,其工作一般是网卡接受数据包,然后通过Driver将数据通过DMA复制到环型缓冲区,然后调用终端处理机制送入CPU进行处理。
网络命名空间(Network Namespace)
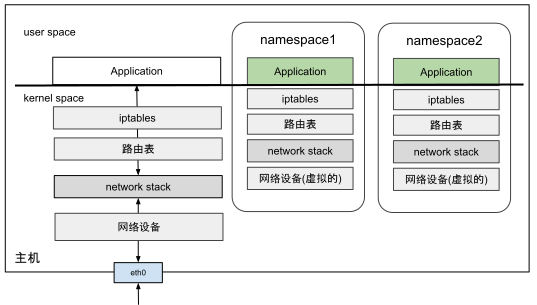
Linux 中实现了 8 种命名空间技术,其主要目的是用于进行资源隔离。其中,网络命名空间是隔离最多,也是最复杂的一种,是现代 Linux 容器技术实现的核心。
网络命名空间允许 Linux 系统内创建多种独立的网络环境,每个环境拥有独立的网络资源,例如IP地址、MAC地址、防火墙规则、路由表、ARP表和虚拟网络设备等,每个命名空间有自己完整的虚拟化的网络协议栈。因此当进程运行在一个网络命名空间时,就像独享一台物理主机(的网络)。
Linux 网桥
Linux 网桥是一种通过 Linux 网络虚拟化技术实现的虚拟交换机,其功能与物理交换机类似。将多个网络接口(如物理网卡、虚拟接口 veth、tap等)桥接后,它们的通信方式与物理交换机的转发行为一致。当数据帧进入 Linux Bridge 时,系统根据数据帧的类型和目的地 MAC 地址执行如下处理:
- 广播帧:转发到所有桥接到该Linux Bridge的设备;
- 单播帧:查找 FDB(Forwarding Database,地址转发表)中 MAC 地址与设备网络接口的映射记录:
- 未找到:进行泛洪(flooding),将数据帧发送到所有接口,并根据相应将设备的网络接口与 MAC 记录到 FDB;
- 若找到:直接将数据帧发送到对应的网络接口。
网桥和物理网卡的关联
使用 Proxmox Virtual Environment 的时候,总会对网桥如何知道和网关通信感到奇怪。网桥明明是一个虚拟交换机设备,但是它可以被赋予 IP 地址,还知道和默认网关通信(它自己又不是物理网卡),怎么做到的?
首先,在 PVE 安装的时候,默认的网桥是 vmbr0,安装时会给它定义一个静态 IP 地址。Linux 会将网桥接口地址设置为默认网关,也就是给它分配定义的静态 IP 地址,然后将默认路由指向该网桥。
root@pve-dom:~# ip route ls
default via 192.168.6.1 dev vmbr0 proto kernel onlink
物理网卡连接在网桥设备上。有三种方式可以查看:
bridge link show master vmbr0brctl showip link show type bridge_slave
root@pve-dom:~# ip link show type bridge_slave
2: enp1s0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel master vmbr0 state UP mode DEFAULT group default qlen 1000
    link/ether 58:47:ca:75:ec:f4 brd ff:ff:ff:ff:ff:ff
    altname enx5847ca75ecf4

root@pve-dom:~# bridge link show master vmbr0
2: enp1s0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 master vmbr0 state forwarding priority 32 cost 5
9: fwpr1001p0@fwln1001i0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 master vmbr0 state forwarding priority 32 cost 2
17: fwpr9001p0@fwln9001i0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 master vmbr0 state forwarding priority 32 cost 2
21: fwpr9002p0@fwln9002i0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 master vmbr0 state forwarding priority 32 cost 2
41: fwpr4005p0@fwln4005i0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 master vmbr0 state forwarding priority 32 cost 2
45: fwpr1002p0@fwln1002i0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 master vmbr0 state forwarding priority 32 cost 2
77: fwpr101p0@fwln101i0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 master vmbr0 state forwarding priority 32 cost 2
105: fwpr3001p0@fwln3001i0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 master vmbr0 state forwarding priority 32 cost 2
可以看到 enp1s0 连接在 vmbr0 上。
数据包如何通过网桥走向物理卡?
当主机产生一个数据包,其目标 IP 不在本地网络时,会查找路由表,匹配默认路由,决定从 vmbr0 发出。此时:
- 二层封装:数据包在
vmbr0接口上会被封装成以太网帧,目标 MAC 地址为网关(如 192.168.6.1)的 MAC 地址 - 网桥处理:
vmbr0是一个二层的虚拟交换机,因此不同于 IP 选路,它是通过自己的 MAC 地址表(FDB,地址转发表)来查看 MAC 地址对应的端口。命令:bridge fdb show。- 如果网关的 MAC 地址之前通过学习记录在某个物理端口上(例如
enp1s0)上,则数据帧直接从enp1s0转发出去。 - 如果尚未学习,则广播到所有端口(泛洪),最终从物理网卡发出。
- 如果网关的 MAC 地址之前通过学习记录在某个物理端口上(例如
- 物理网卡发送:数据帧从 eth0 发送到物理链路上。
root@pve-dom:~# bridge fdb show
4c:10:d5:83:94:ab dev enp1s0 master vmbr0
94:83:c4:54:be:a8 dev enp1s0 master vmbr0
bc:fc:e7:72:d4:3e dev enp1s0 master vmbr0
结合ARP表,可以判断通过 vmbr0 发出的报文,会发往 94:83:c4:54:be:a8,也就是发往默认网关:
root@pve-dom:~# ip neighbor show
192.168.6.1 dev vmbr0 lladdr 94:83:c4:54:be:a8 REACHABLE
192.168.6.10 dev vmbr0 lladdr bc:24:11:04:0d:dc REACHABLE
192.168.6.20 dev vmbr0 lladdr bc:fc:e7:72:d4:3e REACHABLE
192.168.6.11 dev vmbr0 lladdr bc:24:11:9b:89:b0 STALE
192.168.6.23 dev vmbr0 lladdr bc:24:11:44:df:46 REACHABLE
192.168.6.222 dev vmbr0 lladdr 7e:71:bb:c6:01:39 STALE
网桥的IP地址如何理解?
在 Linux 中,网桥是一个虚拟的二层交换设备,给它分配 IP 地址时,这个 IP 地址实际不属于任何一个物理接口,而是属于网桥这个虚拟接口本身。这和传统路由器(每个物理端口独立 IP)的概念不同,
首先从网桥的本质理解,它本身是一个 OSI 二层交换机,根据 MAC 地址表(FDB)在端口之间转发以太网帧。
- 端口:可以是物理网卡(如
eth0)、虚拟网卡(veth,tab等),它们是网桥的成员(slave),没有自己的三层 IP。 - 转发:当数据帧进入网桥时,网桥根据目标 MAC 决定从哪个端口出发,完全不涉及 IP 地址。
那既然网桥工作在二层,转发以太网帧也不涉及 IP,那分配 IP 干嘛?
给网桥分配 IP 地址,是将 IP 分配给网桥虚拟接口 br0 上的,本身实际上不属于任何其他的端口,其目的:允许主机通过该 IP 访问网桥本身(如管理、提供网关服务)或者让网桥参与三层路由。分配 IP 的网桥相当于一个 三层交换机。其同时具备:
- 二层交换:在端口间转发数据帧
- 三层交换:主机可以通过
br0的 IP 与外部通信,或者让其他设备以br0为网关。
虚拟网络设备TUN/TAP
TUN 和 TAP 是 自 Linux 2.4.x 引入的虚拟网卡设备,专为用户空间(user space)与内核空间(kernel space)之间的数据传输设计。
- TUN:工作在 Layer 3,处理 IP 数据包。它模拟一个网络层接口,使得用户空间能够直接收发 IP 数据包。
- TAP:工作在 Layer 2,用于处理以太网帧。TAP 设备传输完整的以太网帧,使得用户空间程序可以处理原始以太网帧。
TUN/TAP 设备对应的字符设备文件为 /dev/net/tun。当用户空间程序打开字符设备文件时,此时 TUN/TAP 的字符设备驱动会创建并注册相应的虚拟网卡,默认命名为 tunX 或者 tapX。随后,用户空间程序读写该描述符,就可以和内核网络栈进行数据交互了。
一个TUN设备构建VPN的例子
- 首先,一个普通的用户程序发起网络请求,此时将默认路由设置为
tun0设备。 - tun0 设备的字符设备文件
/dev/net/tun由 VPN 程序打开。因此 VPN 会读取用户发送的网络数据包,并进行封装加密。 - 经过VPN封装后的数据再次被写入网络栈,这次通过
eth0(物理网卡)发送到目标网络
虚拟网卡 Veth
虚拟网卡虚拟化的是一根网线,从网线的一头发送数据,另外一头就会收到数据。因此Veth也可以被说成是“一对设备(Veth pair)“,这在使用 iproute2 配置时也能够体现(指定 peer name 参数)。veth 创建是成对创建的(因为一根网线有两个水晶头),如果只想创建一个虚拟网卡,可以创建两个只使用一个。
Veth 设备的典型使用场景时连接相互隔离的网络命名空间,使它们能够进行通信。一般来说,两个不同命名空间的网卡彼此网络时隔离的,但是通过将其中的 veth 相连,则可以实现两个 ns 进行通信。如果需要多个 ns 进行通信,还可以将不同 ns 中的 veth 连接到一个 bridge 中。
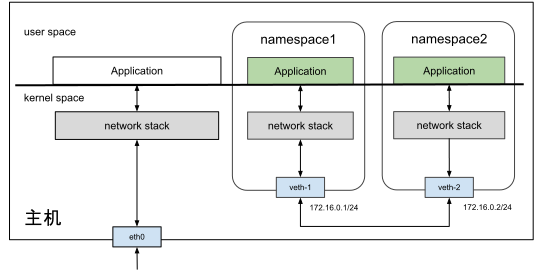
实践
目标
创建三个不同的名字空间,分别在其中创建三个不同的网卡,通过网桥进行互联。其中网桥放置到第四个名字空间。
虚拟网卡veth本质上是一根网线,可以考虑将网线的一端放在主机名字空间中。因此,需要创建 6 个 veth(3个 veth pair),一个网桥设备,3个 ns。
1. 创建 veth
root@debian:/home/wuyaxu# ip link add veth1-host type veth peer name veth-ns1
root@debian:/home/wuyaxu# ip link add veth2-host type veth peer name veth-ns2
root@debian:/home/wuyaxu# ip link add veth3-host type veth peer name veth-ns3
root@debian:/home/wuyaxu# ip link show
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
2: ens18: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP mode DEFAULT group default qlen 1000
    link/ether bc:24:11:b0:4d:5f brd ff:ff:ff:ff:ff:ff
    altname enp6s18
    altname enxbc2411b04d5f
3: docker0: <NO-CARRIER,BROADCAST,MULTICAST,UP> mtu 1500 qdisc noqueue state DOWN mode DEFAULT group default
    link/ether 76:50:c7:40:e5:76 brd ff:ff:ff:ff:ff:ff
17: veth-ns1@veth1-host: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000
    link/ether ea:da:44:84:1c:ef brd ff:ff:ff:ff:ff:ff
18: veth1-host@veth-ns1: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000
    link/ether 7a:10:c2:c1:73:c8 brd ff:ff:ff:ff:ff:ff
19: veth-ns2@veth2-host: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000
    link/ether ee:2e:28:68:f2:22 brd ff:ff:ff:ff:ff:ff
20: veth2-host@veth-ns2: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000
    link/ether d2:aa:8a:85:3a:f0 brd ff:ff:ff:ff:ff:ff
21: veth-ns3@veth3-host: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000
    link/ether da:db:89:30:0c:ae brd ff:ff:ff:ff:ff:ff
22: veth3-host@veth-ns3: <BROADCAST,MULTICAST,M-DOWN> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000
    link/ether 32:42:2b:db:c8:e5 brd ff:ff:ff:ff:ff:ff
root@debian:/home/wuyaxu#
2. 将创建的 veth 对的一端防止在不同的 namespace 中
root@debian:/home/wuyaxu# ip netns add ns1
root@debian:/home/wuyaxu# ip netns add ns2
root@debian:/home/wuyaxu# ip netns add ns3
root@debian:/home/wuyaxu# ip netns add ns4
root@debian:/home/wuyaxu# ip link set veth-ns1 netns ns1
root@debian:/home/wuyaxu# ip link set veth-ns2 netns ns2
root@debian:/home/wuyaxu# ip link set veth-ns3 netns ns3
root@debian:/home/wuyaxu# ip netns exec ns3 ip link show type veth
21: veth-ns3@if22: <BROADCAST,MULTICAST> mtu 1500 qdisc noop state DOWN mode DEFAULT group default qlen 1000
    link/ether da:db:89:30:0c:ae brd ff:ff:ff:ff:ff:ff link-netnsid 0
3. 创建网桥,并将 veth-host 全部接入网桥
root@debian:/home/wuyaxu# ip link add dev br0 type bridge
root@debian:/home/wuyaxu# ip link set br0 up
root@debian:/home/wuyaxu# ip link set veth1-host master br0
root@debian:/home/wuyaxu# ip link set veth2-host master br0
root@debian:/home/wuyaxu# ip link set veth3-host master br0
root@debian:/home/wuyaxu# bridge link show
18: veth1-host@if17: <BROADCAST,MULTICAST> mtu 1500 master br0 state disabled priority 32 cost 2
20: veth2-host@if19: <BROADCAST,MULTICAST> mtu 1500 master br0 state disabled priority 32 cost 2
22: veth3-host@if21: <BROADCAST,MULTICAST> mtu 1500 master br0 state disabled priority 32 cost 2
4. 给 ns 中的网卡分配 IP 地址,启动所有 veth
root@debian:/home/wuyaxu# ip netns exec ns1 ip addr add 10.20.0.1/24 dev veth-ns1
root@debian:/home/wuyaxu# ip netns exec ns2 ip addr add 10.20.0.2/24 dev veth-ns2
root@debian:/home/wuyaxu# ip netns exec ns3 ip addr add 10.20.0.3/24 dev veth-ns3
root@debian:/home/wuyaxu# ip netns exec ns1 ip link set veth-ns1 up
root@debian:/home/wuyaxu# ip netns exec ns2 ip link set veth-ns2 up
root@debian:/home/wuyaxu# ip netns exec ns3 ip link set veth-ns3 up
root@debian:/home/wuyaxu# ip link set veth1-host up
root@debian:/home/wuyaxu# ip link set veth2-host up
root@debian:/home/wuyaxu# ip link set veth3-host up
root@debian:/home/wuyaxu# ip netns exec ns1 ping -c 3 10.20.0.3
PING 10.20.0.3 (10.20.0.3) 56(84) bytes of data.
64 bytes from 10.20.0.3: icmp_seq=1 ttl=64 time=0.023 ms
64 bytes from 10.20.0.3: imp_seq=2 ttl=64 time=0. 031 ms
64 bytes from 10.20.0.3: icmp_seq=3 ttl=64 time=0.033 ms
--- 10.20.0.3 ping statistics ---
3 packets transmitted, 3 received, 0% packet loss, time 2046ms
rtt min/avg/max/mdev = 0.023/0.029/0.033/0.004 ms
root@debian:/home/wuyaxu# ip netns exec ns1 ping -c 3 10.20.0.3
PING 10.20.0.3 (10.20.0.3) 56(84) bytes of data.
64 bytes from 10.20.0.3: icmp_seq=1 ttl=64 time=0.025 ms
64 bytes from 10.20.0.3: icmp_seq=2 ttl=64 time=0.031 ms
64 bytes from 10.20.0.3: icmp_seq=3 ttl=64 time=0.038 ms
--- 10.20.0.3 ping statistics ---
3 packets transmitted, 3 received, 0% packet loss, time 2038ms
rtt min/avg/max/mdev = 0.025/0.031/0.038/0.005 ms
root@debian:/home/wuyaxu#root@debian:/home/wuyaxu# ip netns exec ns3 tcpdump -nvi veth-ns3 icmp tcpdump: listening on veth-ns3, link-type EN10MB (Ethernet), snapshot length 262144 bytes
^C16:22:20.258956 IP (tos 0x0, ttl 64, id 37378, offset 0, flags [DF], proto ICMP (1), length 84)
10.20.0.1 > 10.20.0.3: ICMP echo request, id 2347, seq 1, length 64
16:22:20.258962 IP (tos 0x0, ttl 64, id 36465, offset 0, flags [none], proto ICMP (1), length 84)
10.20.0.3 > 10.20.0.1: ICMP echo reply, id 2347, seq 1, length 64
16:22:21.273478 IP (tos 0x0, ttl 64, id 37421, offset 0, flags [DF], proto ICMP (1), length 84)
10.20.0.1 > 10.20.0.3: ICMP echo request, id 2347, seq 2, length 64
16:22:21.273489 IP (tos 0x0, ttl 64, id 36689, offset 0, flags [none], proto ICMP (1), length 84)
10.20.0.3 > 10.20.0.1: ICMP echo reply, id 2347, seq 2, length 64
16:22:22.297481 IP (tos 0x0, ttl 64, id 37483, offset 0, flags [DF], proto ICMP (1), length 84)
10.20.0.1 > 10.20.0.3: ICMP echo request, id 2347, seq 3, length 64
16:22:22.297492 IP (tos 0x0, ttl 64, id 36862, offset 0, flags [none], proto ICMP (1), length 84)
10.20.0.3 > 10.20.0.1: ICMP echo reply, id 2347, seq 3, length 64
6 packets captured
6 packets received by filter 0 packets dropped by kernel
root@debian:/home/wuyaxu#VLAN
VLAN(Virtual Local Area Network),即 虚拟局域网 ,是将一个物理的 LAN 在逻辑上划分成为多个广播域的通信技术。每个 VLAN 是一个广播域,VLAN 内的主机间可以直接通信,而 VLAN 间则不能够直接互相通信。这样,广播报文就被限制在了一个 VLAN 内。VLAN 工作在 OSI 的二层(数据链路层)。
为什么会存在VLAN?
在以太网的通信中,数据帧必须包含目标 MAC 地址才能够正常的进行传输。因此,计算机在通信前会首先广播 ARP 请求,获取目标主机的 MAC 地址。但是当一个广播域中设备非常多的时候,各种协议机制会产生大量的广播帧,进而导致广播风暴。VLAN 的出现是为了解决这一问题,它的核心功能就是:
- 进行广播域的划分,使得每个 VLAN 形成独立的广播域,从逻辑上隔离同一个物理网络中的设备;相应的:
- 增强局域网的安全性。对于不同 VLAN 内的在传输的时候实现了相互隔离,因此一定程度上避免了不同广播域主机的相互通信,进而降低了攻击面;
- 提升网络的鲁棒性,划分不同的广播域也进而降低了单个广播域网络故障对其他广播域网络的影响;
- 一定程度上提高了网络效率,降低了网络负载。
VLAN 协议
VLAN 的核心思想,是通过在报文中添加 VLAN 信息来实现给报文“打标签”,便于交换机识别不同广播域报文并进行相应的转发。VLAN 划分子网规则主要定义在 IEEE 802.1Q 协议中,其在以太网数据帧中加入 4 个字节的 VLAN 标签(VLAN Tag),用以表示 VLAN 信息。
802.1Q 并非实际封装进入原始以太网帧,而是在 MAC 源地址 和 以太网类型/长度 segments 之间添加一个 32 位的域。
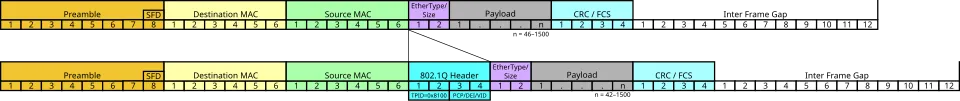
VLAN 标签划分必须遵从如下格式
- TPID(16bit):标签协议标识符(Tag Protocol Identifier,TPID),其数值被设定在 0x8100,用以辨别某个 IEEE 802.1Q 的帧是否已经被搭上 802.1Q 标签。
- PCP(3bit):优先权码点(Priority Code Point,PCP):根据用途对报文进行优先权标记(比如 VoIP 报文一般会被标记高优先权,因此可能会被优先处理和传输)。
- CFI(1bit):标准格式指示(Canonical Format Indicator,CFI):
=0表示 MAC 地址是标准格式;=1表示 MAC 非标准格式。主要用于以太网和令牌环网兼容。 - VID(12bit):虚拟局域网标识符(VLAN Identifier,VID):12 位的域,因此可以划分 4096 个独立的广播域。但是其中部分域的值保留为特定目的。0x000 是保留值,用于表示帧不属于任何一个 VLAN,此时 802.1Q 标签仅仅表示优先权。0xFFF 也是保留值。因此,VLAN ID 的有效取值范围为1~4094。
VLAN 划分子网的方式
VLAN 可以基于 OSI 模型的不同层制定划分的规则。
物理层
直接以交换机端口作为划分依据。适合规模不大的组织。
数据链路层
以每台主机的 MAC 地址作为划分的依据。方法是首先建立一个数据索引,通过将网络设备的 MAC 地址与 VLAN 进行映射。当网络设备连接到端口后,交换机会向 VMPS(VLAN 管理策略服务器)来请求这个数据库,完成端口到 VLAN 的分配。这种策略的扩展性优先,因为需要网络管理员为每个独立设备添加索引。
网络层
以每台设备的 IP 地址作为划分 VLAN 的基础,以子网视为 VLAN 设定的依据。这个方案大幅度降低了网管配置 VLAN 的复杂度。但是缺点是交换机需要对网络层也进行解析,读取IP地址,降低了交换机接受和分派分组的效率。
Tagged 和 Untagged
VLAN 分为 未标记 和 已标记。已标记的 VLAN 在报文中会加上“标记”,因此交换机和路由器可以正确处理。大多数网络设备使用的是 IEEE 802.1Q 标准,用 VLAN ID 区别每个报文分属哪个 VLAN。
未标记的 VLAN 建立在交换机实体连接端口上,通常称为_访问连接端口_。这种 VLAN 在分组中不添加额外的标记信息,每个连接端口本身都会被分配为特定的 VLAN。
VLAN 的缺陷
- VLAN Tag 设计存在缺陷:12 bit 的 VID 无法满足现代大型数据中心或者运营商网络的需求。在大量容器编排系统中更是无法满足需求。
- 跨数据中心通信困难:VLAN 是二层网络技术,而两个独立的数据中心之间只能通过三层网络互通。
虚拟网络通信技术 VXLAN
VXLAN 是 软件定义网络(SDN)的支撑技术。
SDN 的核心思想是在现有的物理网络之上构建一层虚拟网络,通过解耦控制平面(操作系统和网络控制软件)与数据平面(物理设备和通信协议),将网络服务从底层硬件抽象出来,使其能够通过软件编程直接控制。SDN主要由两个部分构成。
Underlay(底层网络):由路由器、交换机等硬件设备组成的物理网络,负责底层数据传输。 Overlay(覆盖网络):基于网络虚拟化技术构建在Underlay之上的 逻辑网络,实现虚拟机、容器等计算资源的互联。 VXLAN 的出现主要是为了解决 VLAN 的设计缺陷。VXLAN(Virtual eXtensible Local Area Network,虚拟可扩展局域网)规范从名字看是 VLAN 的扩展,但是实际上和 VLAN 在设计理念和实现方式上存在本质的不同。VXLAN 自 Linux Kernel 3.12 开始完全支持。
Netfilter 框架
Netfilter 框架是 Linux 自 Kernel 2.4 版本开始实现的一套用于对内核流动的网络数据分组进行数据修改和流向控制的过滤器框架,是 Linux 防火墙的实现技术基础。
Netfilter 在 Linux 内核网络协议栈插入了 5 个钩子,每个钩子可以独立配置对应的回调函数。当数据流经特定的 layer 时,会出发对应的钩子,有配置决定是否执行回调函数对数据进行修改或者引导数据流向。这五个钩子分别为:
- PREROUTING:来自设备的数据包进入协议栈时立即出发。一般用于 目标网络地址转换 (DNAT)
- INPUT:报文经过 IP 路由,确定发往本机,则进行处理。
- OUTPUT:从本机发出的数据包,此时未经过 IP 路由。
- POSTROUTING:从本机网卡发出的数据包,无论是本机的程序所发出还是本机转发,都会出发此钩子,用于 源网络地址转换(SNAT)。
- FORWARD:报文经过 IP 路由后,如果不是发往本机,则会出发。
Netfilter 的 每个钩子 可以注册多个回调函数,因此回调函数注册时需要提供明确的优先级,以便于出发时按照优先级从高到低激活。回调函数集合被称为 回调链(Chained Callbacks),iptables 对这个 Chain 的概念使用很多。Netfilter 提供了 Linux 网络处理的许多核心功能,如数据包过滤、封包处理、地址伪装、网络地址转换、透明代理、访问控制、基于协议类型的连接跟踪、带宽限速等。
Netfilter 是 Linux 内核中设计的网络干预框架,本质上是内核接口,一般要调用这些接口,除了通过内核函数调用以外,系统管理员使用一系列 Xtables 工具实现,例如 iptables、ebtables、arptables、ip6tables 等。这些相当于市 Netfilter 框架的前端。
iptables 工具
iptables 预定了一系列预制行为:
DROP:直接将数据包丢弃REJECT:给客户端返回 Connection Refused 或 Destination Unreachable 报文。QUEUE:将数据包放入用户空间队列,供用户空间的程序处理。RETURN:跳出当前链,该链后续规则不执行。ACCEPT:同意数据包通过,继续执行后续的规则。JUMP:跳转到其他用户自定义的链继续执行REDIRECT:在本机做端口映射。MASQUERADE:地址伪装,自动用修改源 IP 地址来做 NAT。LOG:在/var/log/messages文件中记录日志信息。
内置规则表
iptables 内置了 5 张规则表。规则表本质上是对特定目的的规则钩子和它们的回调函数的一种聚合。内置的这 5 张规则表不可扩展。它们分别是:
- raw 表:用于去除数据包上的连接追踪机制
- mangle 表:用于修改数据包的报文头信息
- nat 表:用于修改数据包的源、目的地址信息,主要用于 NAT
- filter 表:用于对数据包进行过滤,控制到达某条链上的数据包是否继续放行、直接丢弃或者拒绝(ACCEPT, DROP, REJECT)。
- security 表:用于在数据包上应用 SELinux,不常用。
优先级:raw $\rightarrow$ mangle $\rightarrow$ nat $\rightarrow$ filter $\rightarrow$ security
默认情况下,在 iptables 上新增规则时,如果没有指定使用哪张表,会存入 filter 中。
| 规则\行为 | PREROUTING | POSTROUTING | FORWARD | INPUT | OUTPUT |
|---|---|---|---|---|---|
| raw | $\checkmark$ | $\checkmark$ | |||
| mangle | $\checkmark$ | $\checkmark$ | $\checkmark$ | $\checkmark$ | $\checkmark$ |
| nat (Source) | $\checkmark$ | $\checkmark$ | |||
| nat (Destination) | $\checkmark$ | $\checkmark$ | |||
| filter | $\checkmark$ | $\checkmark$ | $\checkmark$ | ||
| security | $\checkmark$ | $\checkmark$ | $\checkmark$ |
Netfilter 的 5 个钩子和 iptables 的 5 个链(PREROUTING、POSTROUTING、FORWARD、INPUT、OUTPUT)是对应的,这 5 条链和内置的 5 张表的规则也是固定的。
用户不能增加自定义表,或者修改已有表和链的关系。但是用户可以:增加自定义链,新增的自定义链和 Netfilter 的钩子 没有 天然的对应关系,即不会被自动触发,只有显式使用 JUMP 行为,从默认的五条链路中跳转过去才能够被执行。
NAT
NAT(Network Address Translation):网络地址转换,是将 IP 数据包中的 IP 地址转换为另外一个地址的过程,因此其工作在第三层,其主要用于实现私有网络访问公共网络的功能。
DNAT
DNAT(Destination NAT) 主要用于将外部的请求目标 IP 地址转换为内部网络中的特定地址,可以用于在防火墙上实现内部网络的端口映射,使得外部用户通过服务器公网 IP 和地址访问内网服务。
# 将内网主机192.168.1.3:8080映射到外部8000端口
iptables -t nat -A PREROUTING -i eth0 -p tcp --dport 8000 -j DNAT --to-destination 192.168.1.3:8080
主要适用场景
- 允许外部用户通过互联网访问内部服务器
- 允许外部用户通过 VPN 连接到内网
- 允许外部用户使用远程桌面协议(RDP)连接到内部 Windows 服务器。
- 一切暴露内部服务到公网 IP 的操作······
SNAT
SNAT(Source NAT) 主要用于将内部网络中的源IP地址转换为公共网络可路由的IP地址。一般在 iptables 中可以通过 -j SNAT --to-source <外部IP> 实现,但是也可以通过 -j MASQUERADE 实现动态 IP 地址转换。
iptables -t nat -A POSTROUTING -o eth0 -s 192.168.6.10/24 -j SNAT --to-source 219.31.44.21